Se fai a ChatGPT la stessa domanda oggi e domani, spesso ottieni due risposte diverse. A volte il tuo brand viene citato, a volte no. La visibilità nell’IA si può davvero misurare?
- Le singole risposte dell’IA sono davvero casuali
- La domanda chiave: ripetere o ampliare?
- Perché l’ampiezza vince
- Tanti prompt compensano le oscillazioni
- Quando le interrogazioni giornaliere hanno comunque senso
- Preciso non significa accurato
- Nel proprio set: stabile per il tuo brand, incerto per i concorrenti
- Cosa ne consegue
Si può misurare in modo affidabile, ma non nel modo suggerito da molti strumenti e guide. Abbiamo analizzato 10.826 serie di misurazioni giornaliere dai dati SISTRIX, su quattro modelli di IA e otto Paesi. Il risultato è chiaro: se vuoi dati affidabili, non devi interrogare sempre lo stesso prompt, ma il maggior numero possibile di prompt diversi.
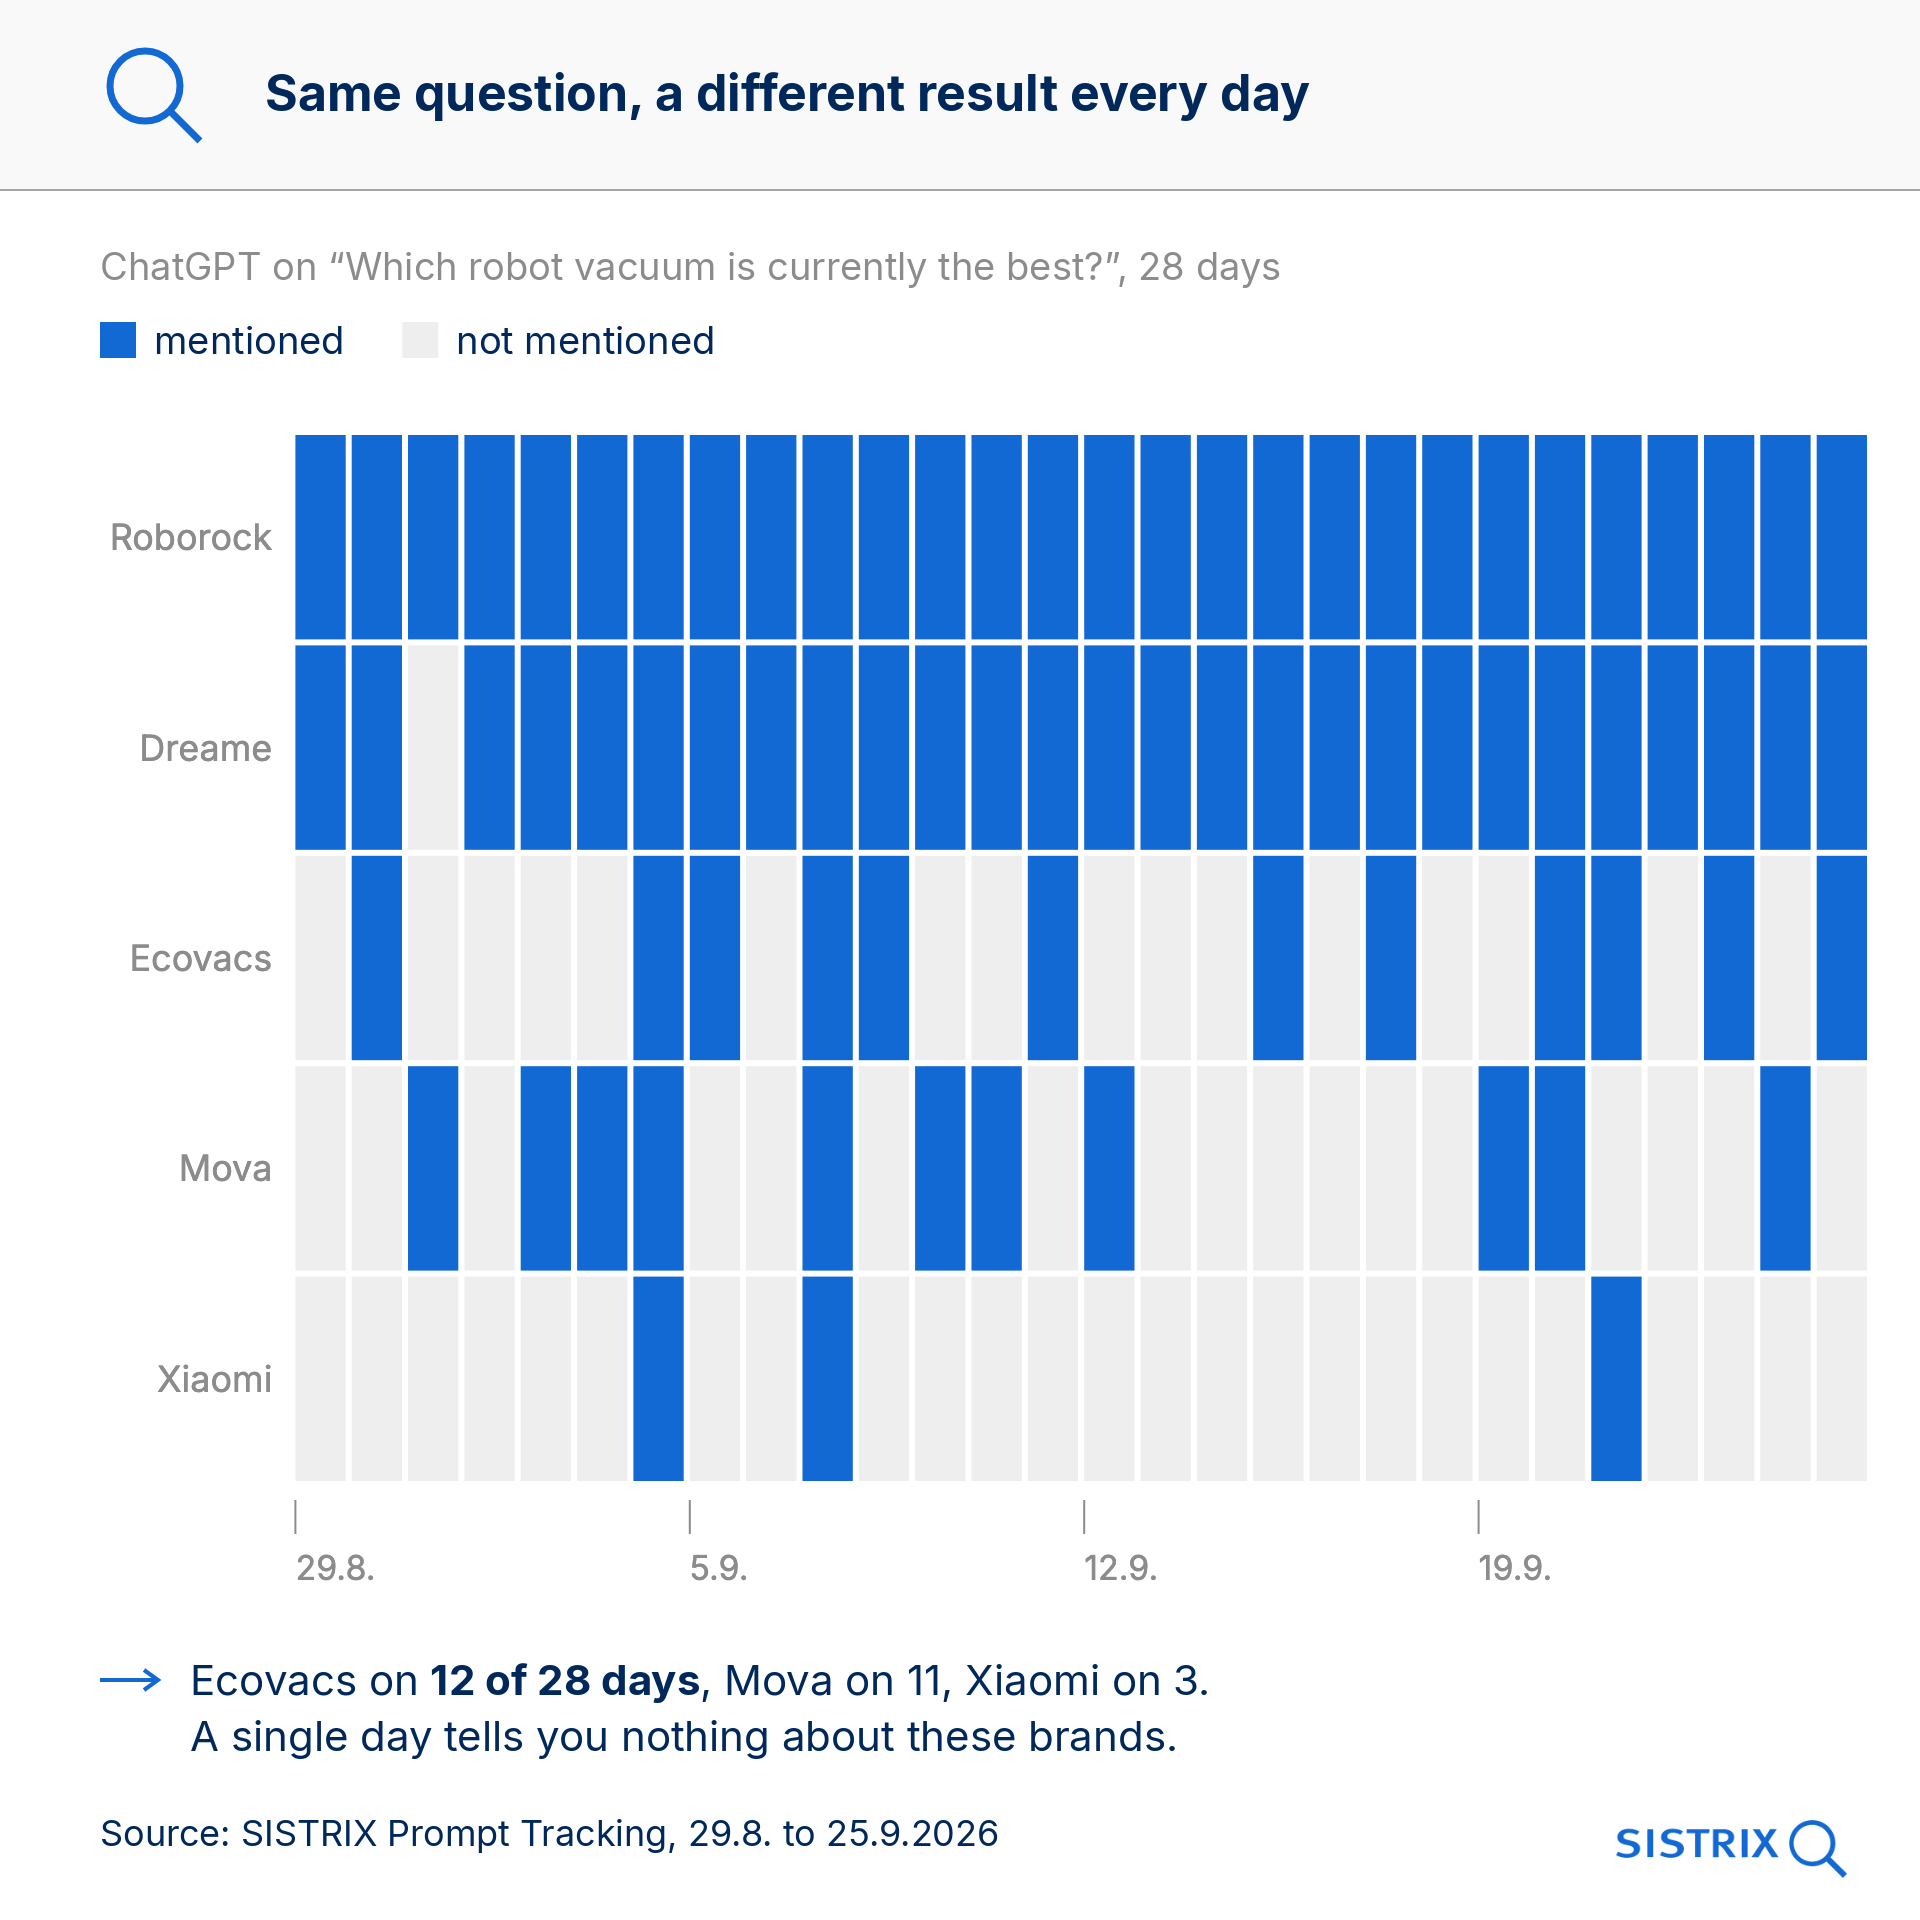
Un esempio dal nostro Prompt Tracking: ogni giorno chiediamo a ChatGPT «Qual è attualmente il miglior robot aspirapolvere?». In quattro settimane Roborock e Dreame vengono citati quasi ogni giorno. Ecovacs compare in 12 giorni su 28, Mova in 11 e Xiaomi in 3, senza uno schema riconoscibile. Chi controlla in un solo giorno, quindi, non scopre praticamente nulla su questi tre brand.
Le singole risposte dell’IA sono davvero casuali
In un articolo che merita di essere letto, intitolato «There Is No “Accuracy” in AI Search Tracking – Only Precision», Mike King di iPullRank ha mostrato di recente quanto le risposte dell’IA varino da un’esecuzione all’altra. Si basa su un esperimento di Mike Sonders con 12 prompt e 100 esecuzioni ciascuno in ChatGPT: il 72 % dei brand compariva in meno di una risposta su cinque.
I nostri dati lo confermano su una base molto più ampia. Di tutti i brand che compaiono nelle risposte a un prompt, il 70 % compare in meno di un giorno su cinque. Solo il 6 % è presente in almeno quattro giorni su cinque. Questo vale allo stesso modo per ChatGPT, AI Overviews, AI Mode e Perplexity.
Una singola risposta, quindi, dice poco. La domanda è come ricavare un dato affidabile da tante risposte incerte.
La domanda chiave: ripetere o ampliare?
Supponiamo di avere un budget di 20 interrogazioni. Puoi interrogare un prompt per 20 giorni, 20 prompt diversi una volta ciascuno o qualsiasi combinazione intermedia. Quale distribuzione fornisce la risposta più precisa alla domanda «In quante risposte compare il mio brand?»
La risposta che emerge dalle 10.826 serie di misurazioni è chiara. Supponiamo che un brand compaia in realtà nel 25 % delle risposte. Se interroghi un prompt per 20 giorni, la tua misurazione può collocarsi ovunque tra lo 0 e il 59 %. Con 20 prompt diversi in un solo giorno, si colloca tra il 16 e il 35 %, con 100 prompt tra il 21 e il 29 %.
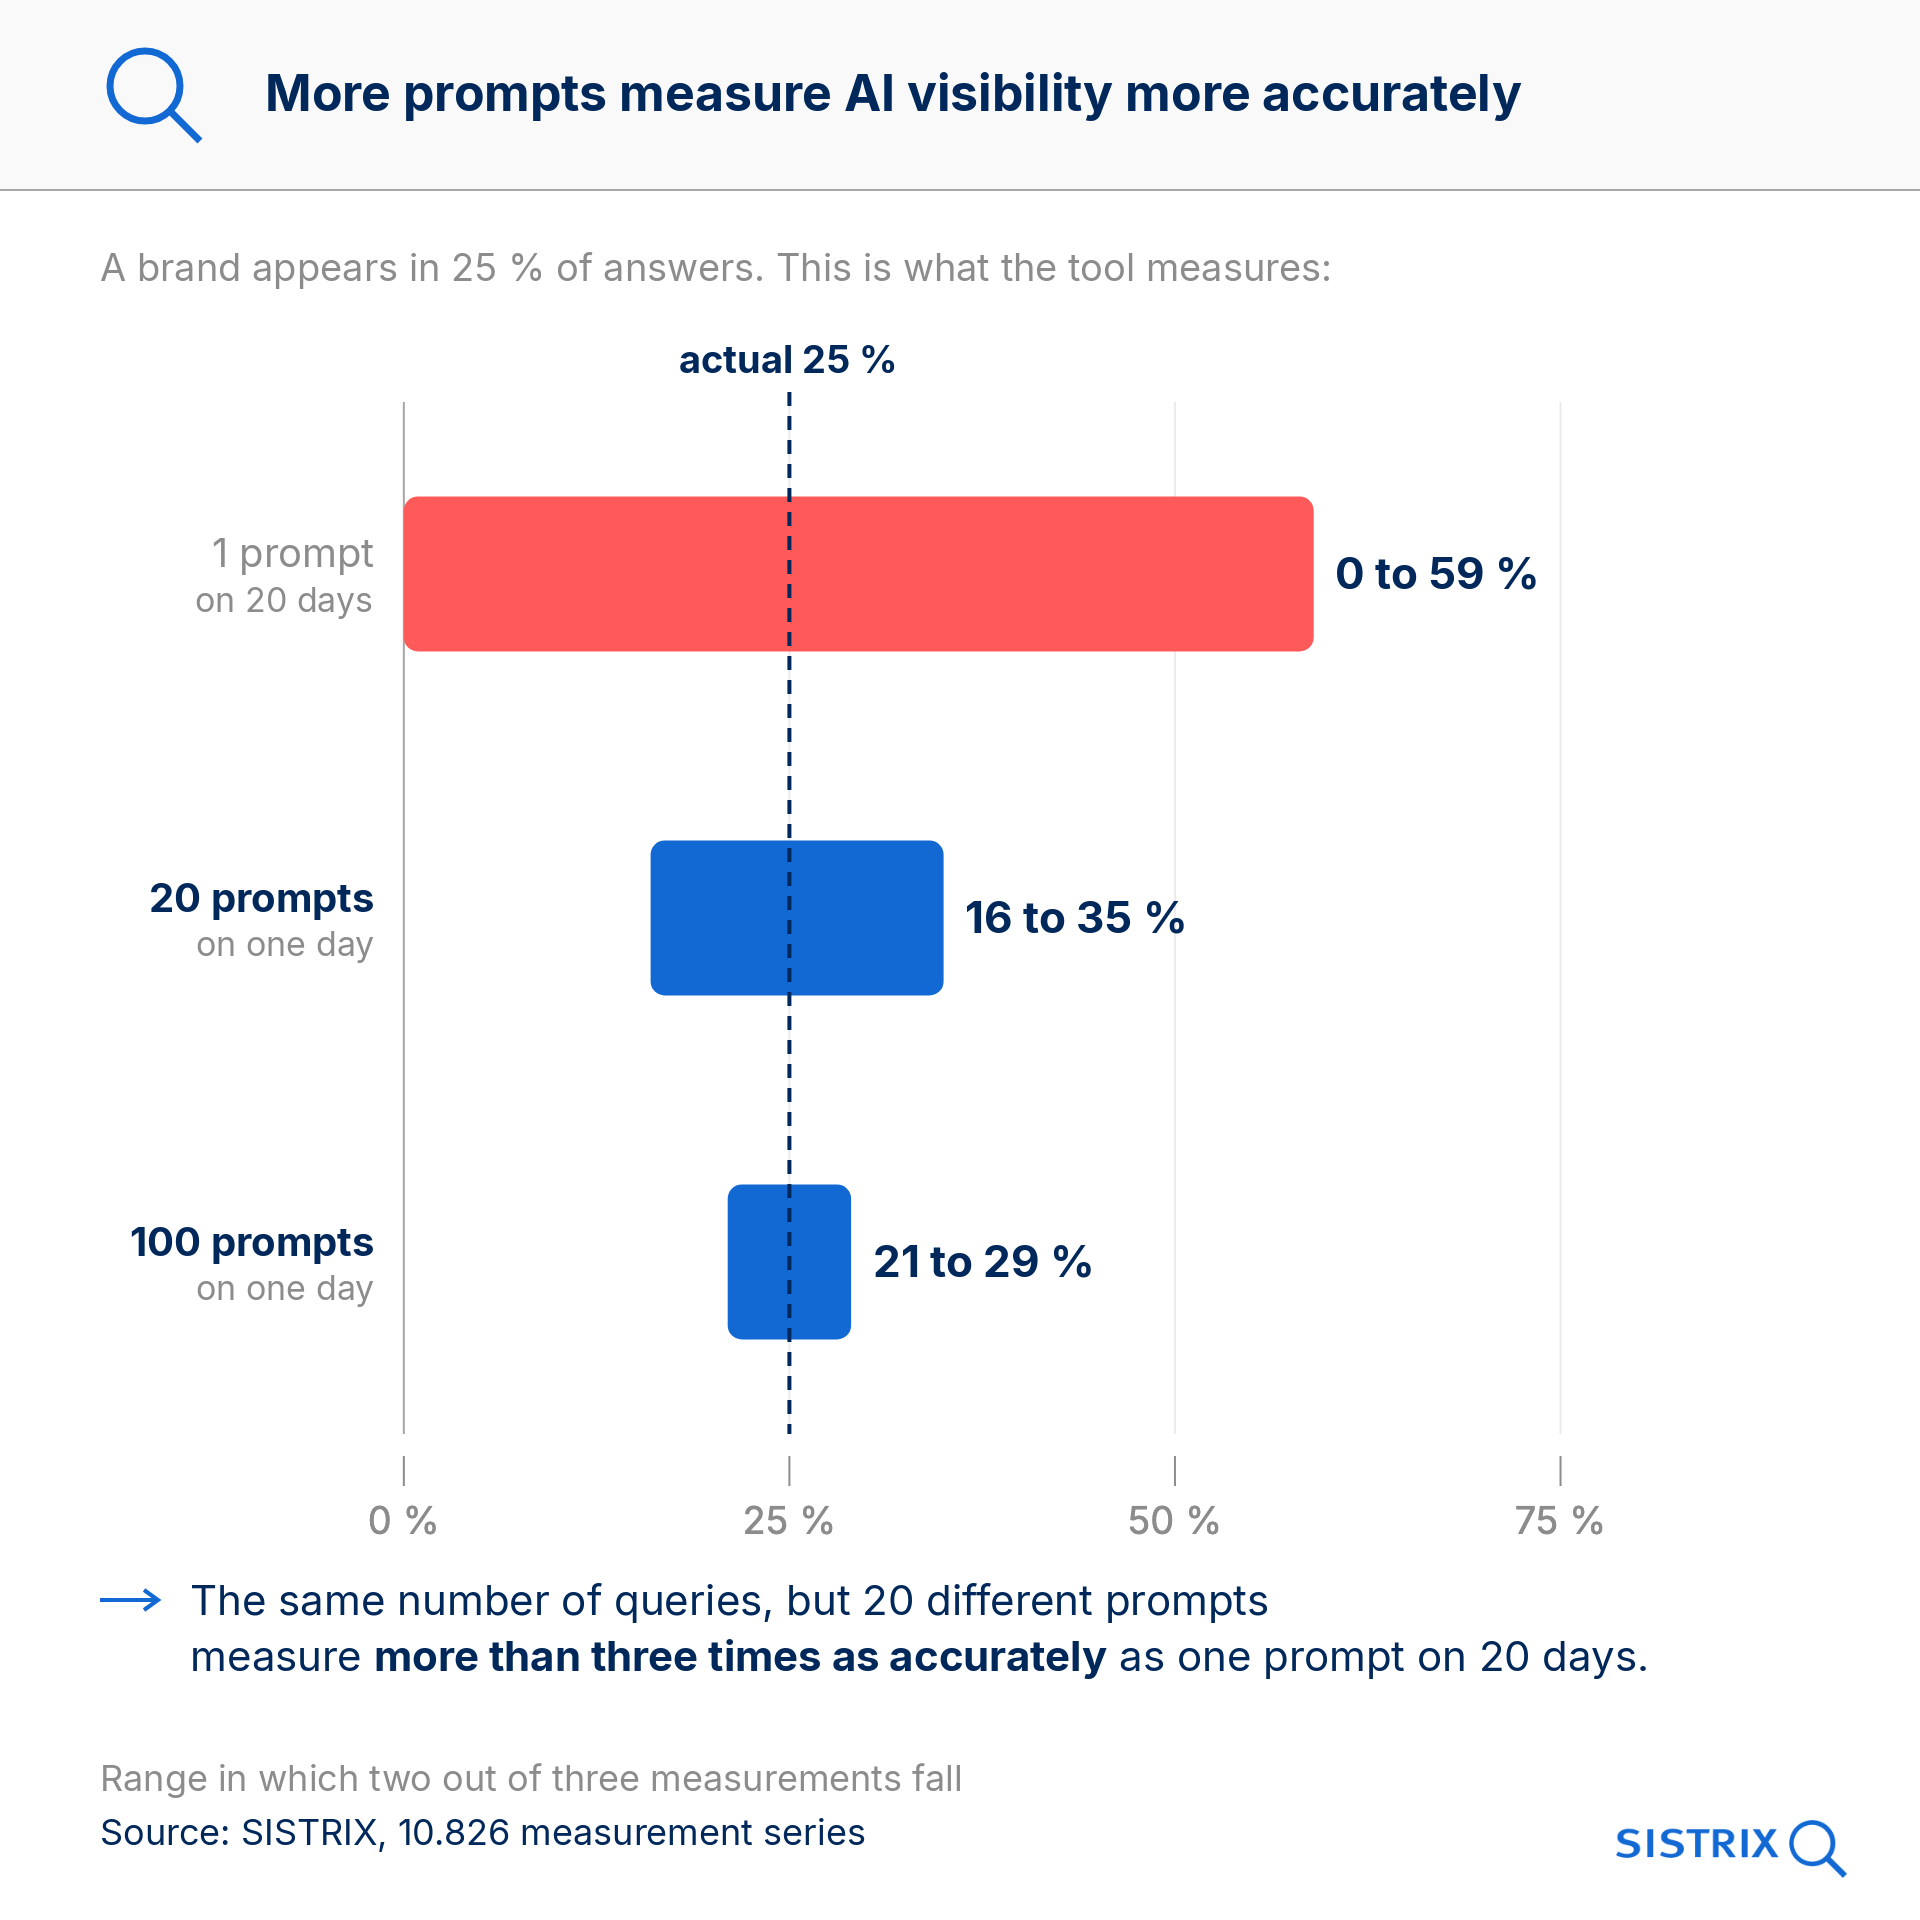
Dietro questi intervalli ci sono deviazioni tipiche dal valore reale: ±34 punti percentuali con un prompt, ±9,5 con 20 e ±4,2 con 100 prompt. Deviazione tipica significa che in circa due casi su tre la misurazione rientra in questo intervallo, e nel 95 % dei casi nel doppio.
A parità di sforzo, la misurazione con 20 prompt diversi è più di tre volte più precisa di quella con un solo prompt in 20 giorni. Il quadro è quasi identico in tutti e quattro i modelli e in tutti e otto i Paesi: con 20 prompt la deviazione è ovunque tra ±9 e ±10 punti.
Perché l’ampiezza vince
Il motivo sta in due tipi di variabilità. Lo stesso prompt fornisce risposte diverse da un giorno all’altro. Ma prompt diversi forniscono risposte ancora più diverse: per una domanda il brand è quasi sempre presente, per la successiva quasi mai. In media, le differenze tra i prompt sono 2,4 volte più grandi della variabilità di un singolo prompt nel corso dei giorni.
La ripetizione agisce solo sulla più piccola delle due. Con 20 prompt resta una soglia minima di ±7,6 punti, per quante ripetizioni si facciano. Per scendere sotto questa soglia servono più prompt diversi.
In pratica, se vuoi misurare la visibilità nell’IA di un brand, è meglio interrogare 100 prompt a settimana che 15 prompt al giorno. Lo sforzo è simile, ma il risultato è molto più solido.
Tanti prompt compensano le oscillazioni
Il SISTRIX AI Check mostra quanto bene funzioni nella pratica. Per 60 brand per Paese in Germania, Stati Uniti, Regno Unito, Francia, Italia e Spagna abbiamo monitorato come variano i loro dati di settimana in settimana.
Tra i prompt in cui un brand viene citato, ogni settimana ne cambia tra il 20 e il 55 %: il brand esce da alcune risposte e compare in altre nuove. Per ChatGPT e AI Mode si tratta di circa la metà, per AI Overviews di circa un prompt su cinque. Eppure il numero totale di menzioni cambia di solito, al netto, solo dal 4 al 10 %. E più prompt ha un brand, più stabile è la sua curva. Per i brand con meno di 100 prompt, la visibilità nell’IA oscilla in mediana di ±5,7 % da una settimana all’altra, a partire da 10.000 prompt solo di ±1,9 %.
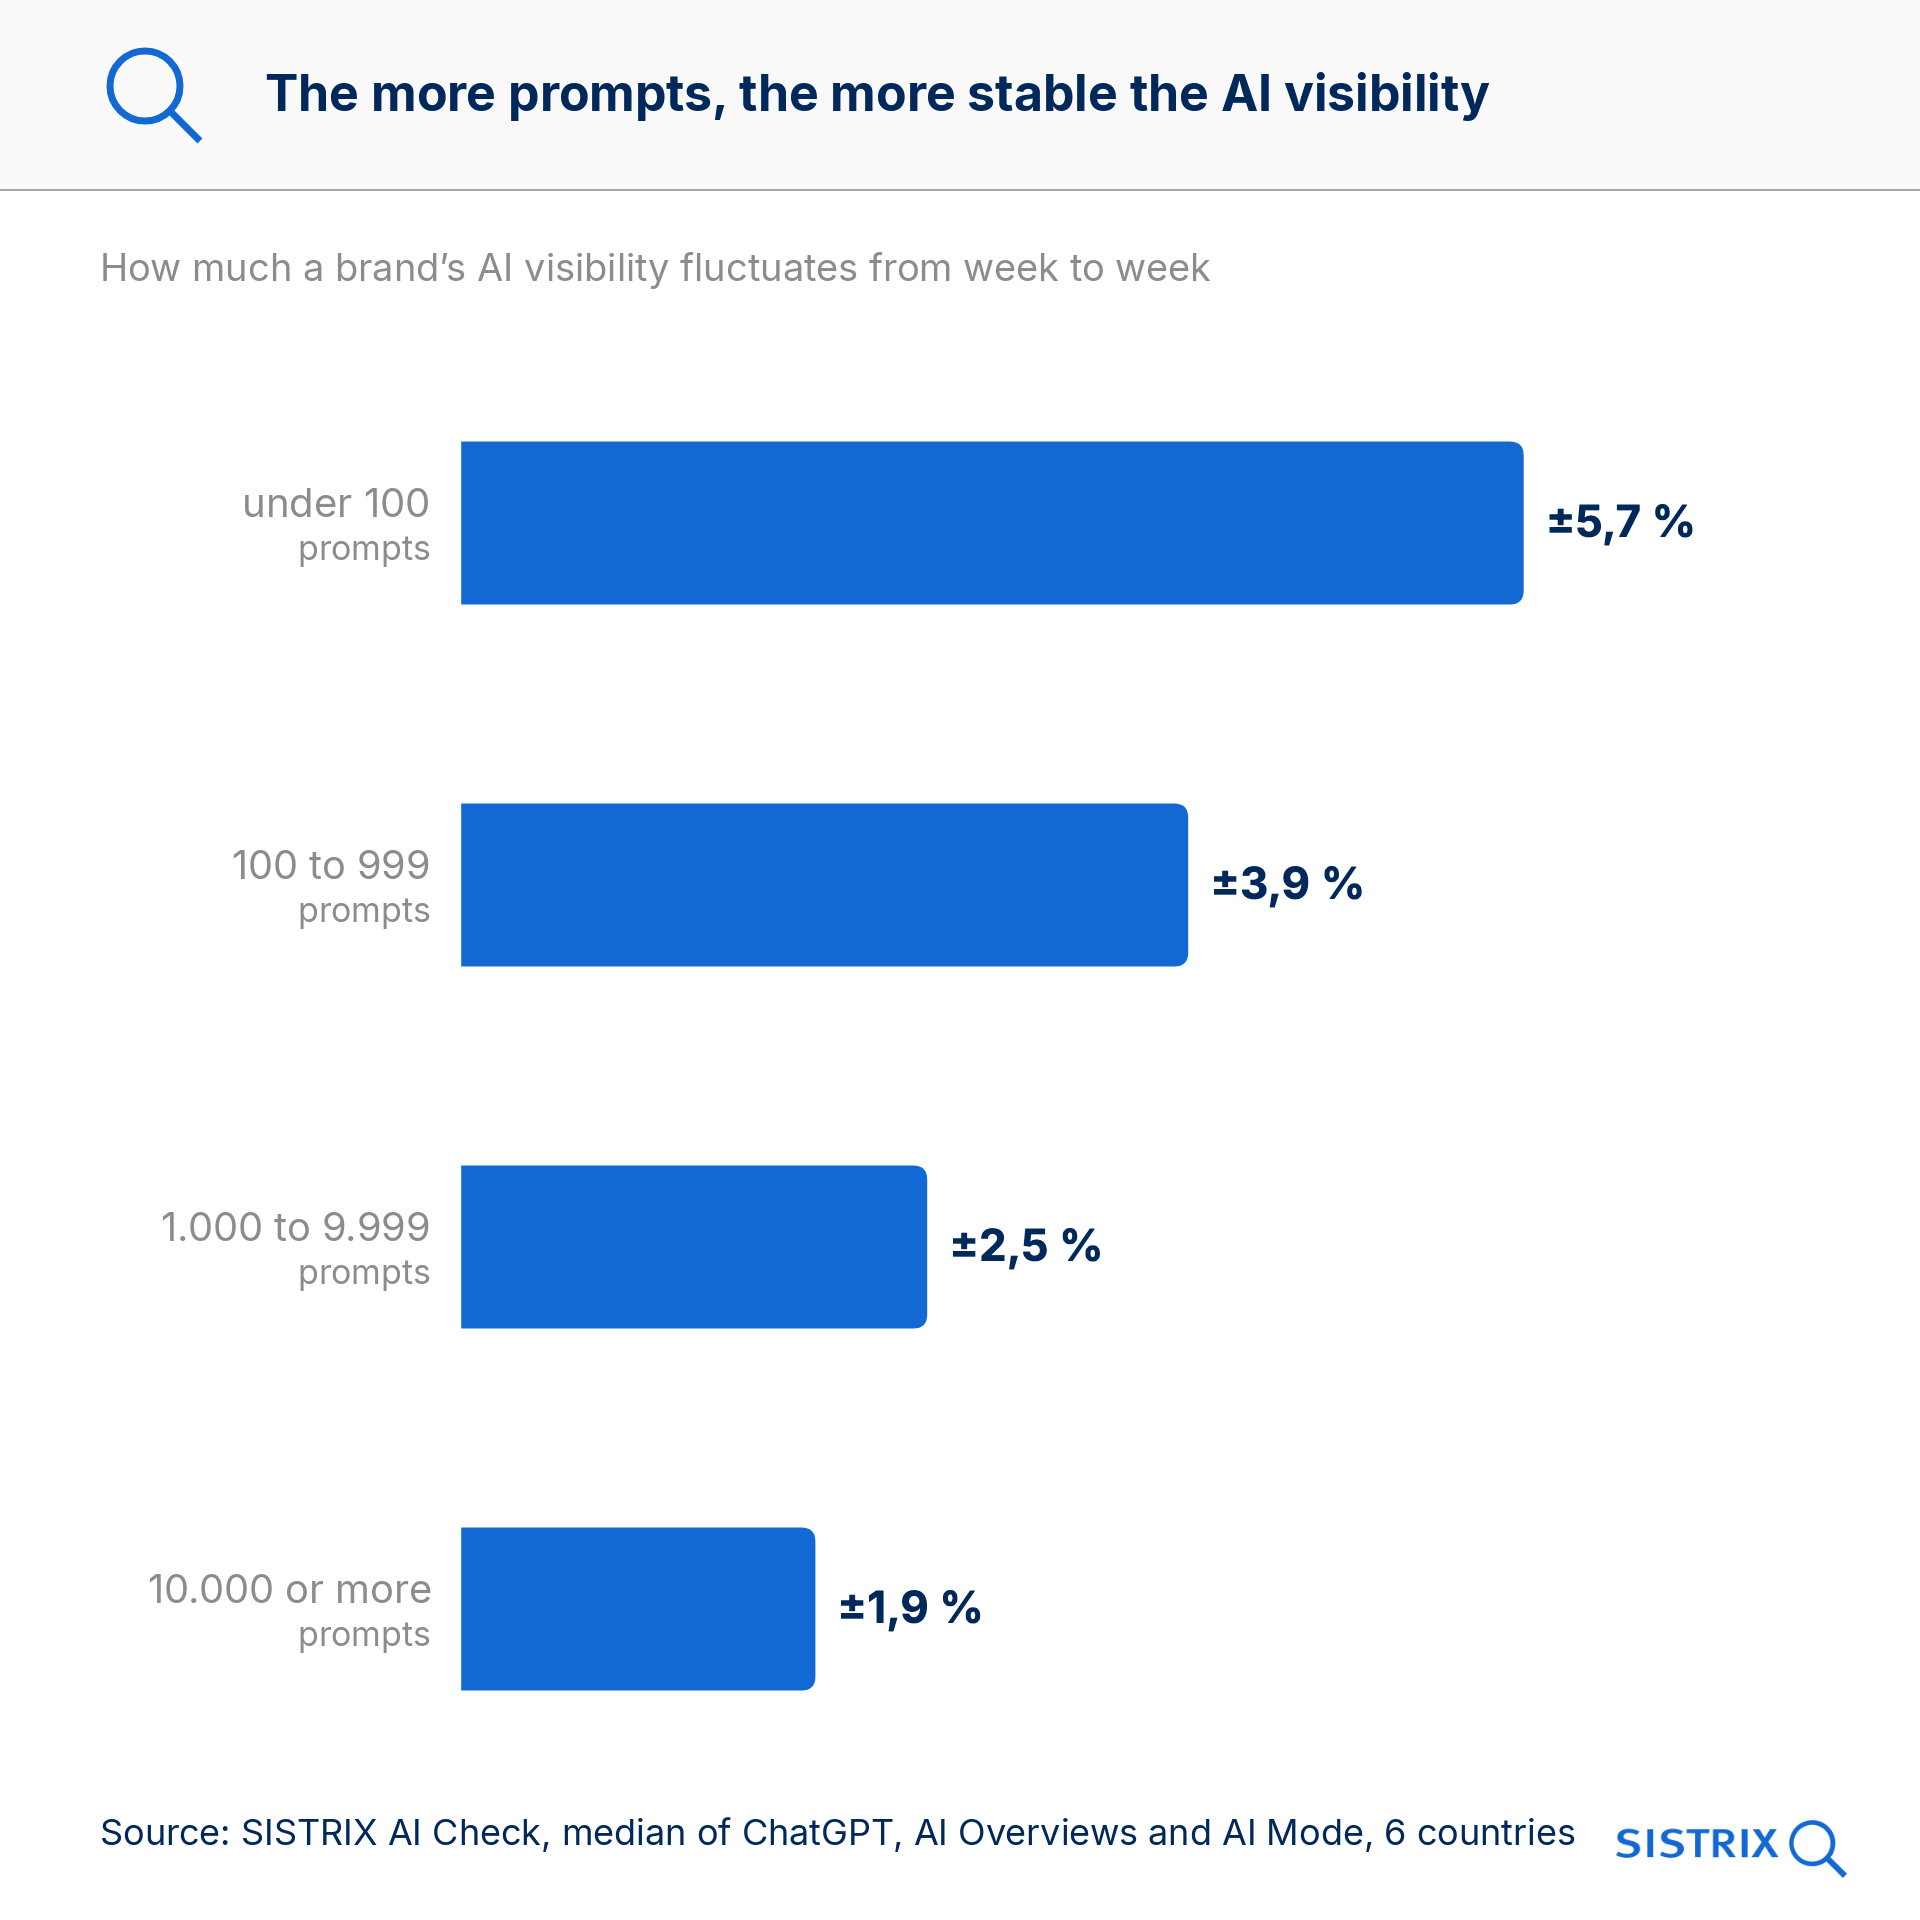
Misuriamo lo scostamento dal trend del singolo brand, al netto delle variazioni dell’insieme complessivo dei prompt. L’unica eccezione sono i brand molto grandi in AI Overviews, con ±3,1 %: lì le variazioni nell’insieme dei prompt incidono più della casualità delle risposte.
Le singole risposte oscillano molto, ma il dato calcolato su molti prompt resta stabile. È esattamente l’effetto che serve per una misurazione affidabile.
Quando le interrogazioni giornaliere hanno comunque senso
Su un punto iPullRank ha ragione: la ripetizione non è inutile. Serve solo a rispondere a un’altra domanda.
«Quanto sono visibile?» si risolve con l’ampiezza. «È cambiato qualcosa?» si risolve con la ripetizione. Se il set di prompt resta invariato, la differenza tra i prompt si annulla nel confronto e resta solo la variabilità da un giorno all’altro. Con 20 prompt, il valore giornaliero ha una precisione di ±4,8 punti, la media settimanale di ±1,8 punti.
Se dopo un intervento vuoi sapere se qualcosa si è mosso, quindi, non confrontare singoli giorni, ma medie settimanali. La media giornaliera su 20 prompt oscilla tipicamente da 4 a 5 punti, e un giorno su dieci di 10 punti o più, senza che sia cambiato nulla.
Per questo molti strumenti calcolano la media dei valori giornalieri su una finestra mobile di 7 giorni. Per le variazioni ha senso, per il livello serve a poco. Misurati su sette giorni, 20 prompt hanno una precisione di ±7,9 punti, appena meglio che in un solo giorno (±9,5). Nemmeno con un numero illimitato di giorni si scende sotto ±7,6, perché la finestra compensa solo la variabilità giornaliera, non la scelta dei prompt. Le stesse 140 interrogazioni, distribuite su 140 prompt diversi in un solo giorno, arrivano invece a ±3,6 punti.
Preciso non significa accurato
iPullRank distingue tra precisione (quanto è dispersa una misurazione?) e accuratezza (centra il valore reale?) e conclude che nella visibilità nell’IA non esiste un valore reale rispetto al quale misurare l’accuratezza.
Noi la vediamo diversamente. Se si definisce il valore reale come il tasso di menzione sull’insieme di tutti i prompt di un mercato, come quello rappresentato dall’AI Check, l’accuratezza si può misurare. Ed è proprio questa la fonte di errore maggiore.
Abbiamo confrontato la visibilità dei brand in set di prompt scelti da loro stessi con la loro visibilità nell’AI Check, in entrambi i casi come quota rispetto ai concorrenti. Se non ci fosse un effetto di selezione, il proprio set risulterebbe a volte più alto e a volte più basso, quindi migliore in circa la metà dei casi. In realtà il proprio brand risulta migliore in tre casi su quattro, spesso in modo netto. A seconda dei concorrenti presi come riferimento, la quota va dal 63 all’80 %.
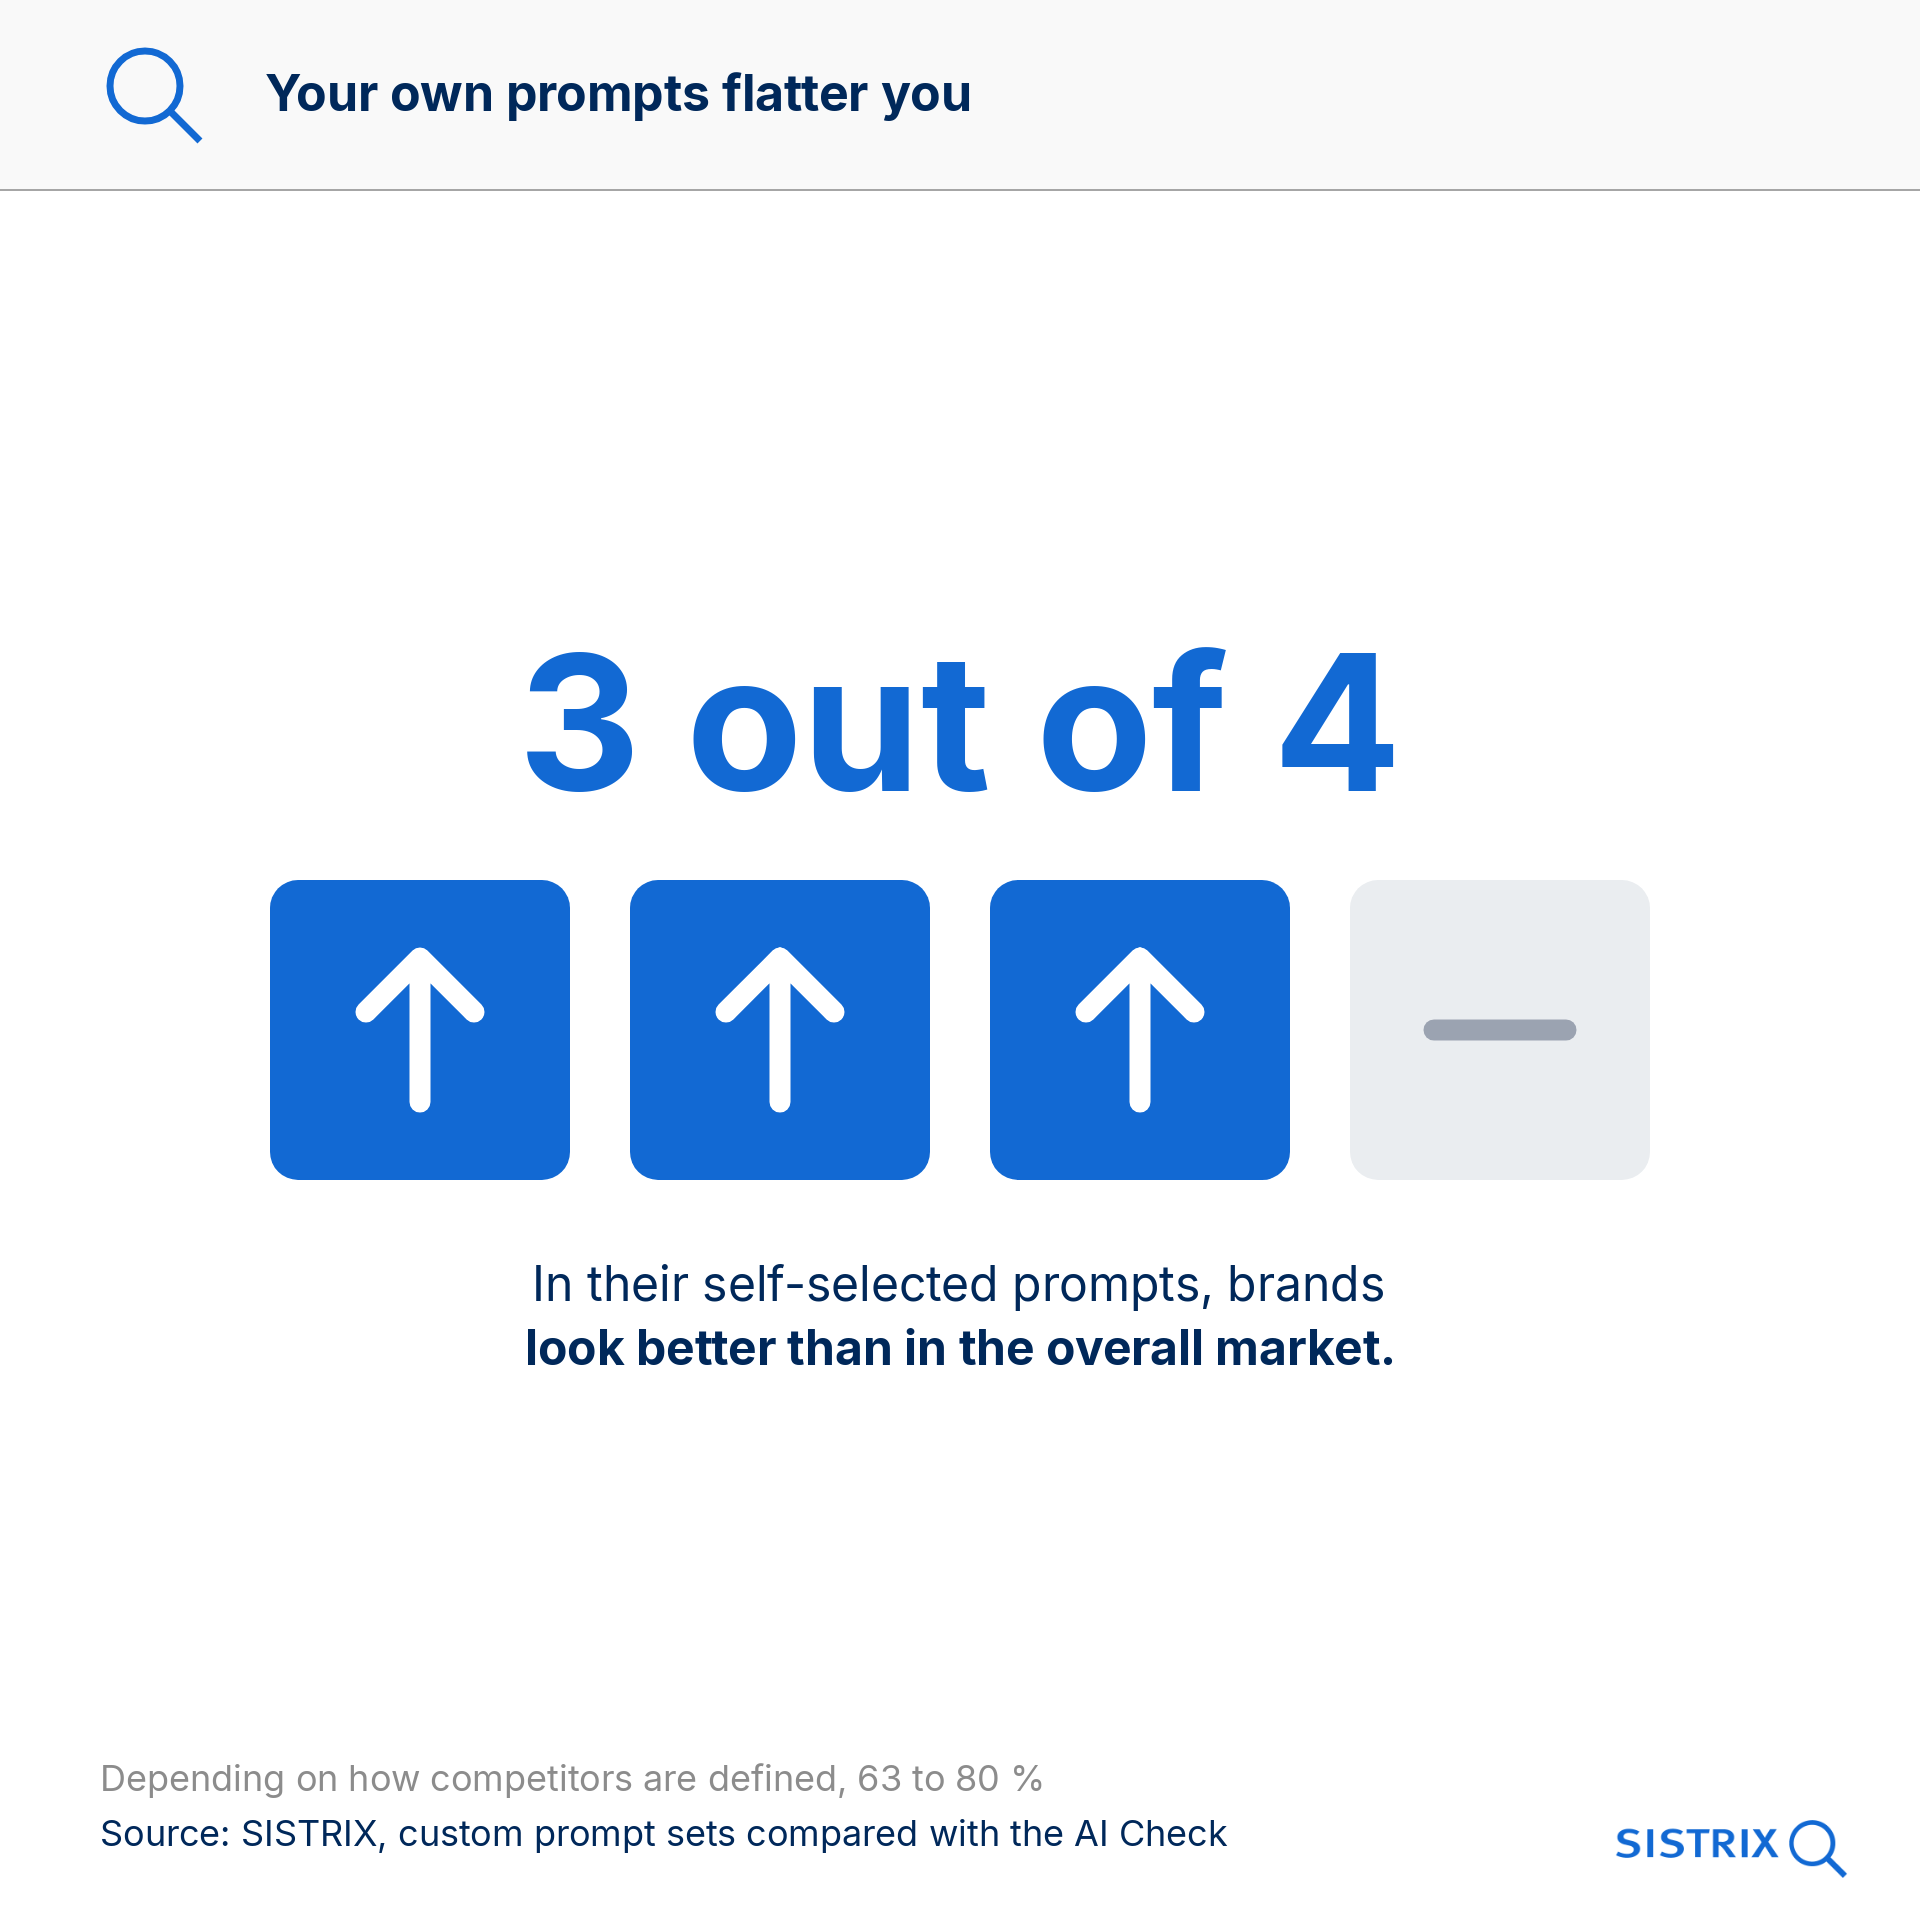
Non è un errore di misurazione, ma un effetto di selezione. Chi sceglie i prompt da sé sceglie domande vicine al proprio brand. Lo strumento è preciso, ma manca il bersaglio, come il secondo giocatore di freccette nell’immagine dell’articolo di iPullRank.
Nel proprio set: stabile per il tuo brand, incerto per i concorrenti
Un’ultima evidenza ridimensiona l’immagine del «lancio dei dadi». Nei set di prompt scelti autonomamente, il proprio brand si discosta dal suo risultato abituale solo nel 6 % delle esecuzioni giornaliere. La maggior parte dei prompt lo cita quasi sempre o quasi mai.
Anche questo dipende dalla selezione: chi costruisce i prompt attorno al proprio brand misura bene il proprio brand e tutti gli altri solo marginalmente. Le affermazioni più incerte riguardano quindi i concorrenti e i brand marginali, cioè quel 70 % che compare solo in pochi giorni. Se da un piccolo set di prompt scelto da te deduci che un concorrente è cresciuto, fai attenzione. Per il confronto con i concorrenti è meglio un insieme di prompt che non sia stato selezionato in funzione di un brand.
Cosa ne consegue
Cinque consigli per chi misura la visibilità nell’IA:
- Più prompt invece di più esecuzioni. Per la domanda «Quanto sono visibile?», il numero di prompt diversi è la leva decisiva. Con 20 prompt si ottiene solo una stima approssimativa (±10 punti). Per ±5 punti servono circa 70 prompt, per ±3 punti circa 200. Come regola pratica: per dimezzare l’incertezza servono quattro volte più prompt.
- Una volta a settimana basta per l’ampiezza. Un set di prompt ampio interrogato settimanalmente è più affidabile di uno piccolo interrogato ogni giorno. A parità di interrogazioni, 140 prompt una volta a settimana hanno una precisione di ±3,6 punti, mentre 20 prompt al giorno con una finestra di 7 giorni arrivano solo a ±7,9. Se hai il budget, investilo in prompt aggiuntivi, non in interrogazioni più frequenti.
- Valutare le variazioni con le medie settimanali. I valori giornalieri saltano da 5 a 10 punti senza motivo. Se con un set di prompt fisso vuoi sapere se un intervento funziona, confronta le medie settimanali. Con 20 prompt la loro incertezza è di ±1,8 punti, mentre per un singolo giorno è di ±4,8.
- Misurare il livello sul mercato, le variazioni nel proprio set. I prompt scelti autonomamente mostrano i trend in modo affidabile, ma di solito restituiscono un livello assoluto troppo favorevole. Per capire quanto sia davvero visibile il tuo brand, un ampio insieme di prompt come il SISTRIX AI Check è più adatto di qualsiasi set scelto da te. Lì i dati più significativi sono le quote come la Share of Voice, perché compensano le variazioni dell’insieme complessivo.
- Leggere con cautela i dati dei concorrenti nel proprio set. Un set di prompt scelto autonomamente è tagliato su misura per il proprio brand. I concorrenti vi compaiono solo marginalmente e oscillano molto di più. Nell’AI Check non è così: lì ogni brand viene misurato allo stesso modo, e la stabilità del suo dato dipende solo da quanti prompt lo contengono.
Ne deriva una semplice divisione dei compiti. Quanto sia visibile un brand lo mostra lo sguardo su moltissimi prompt non selezionati in funzione di quel brand: nell’AI Check, la visibilità nell’IA dei brand con più di 1.000 prompt oscilla solo da ±1 a 3 % a settimana. Se un intervento funziona lo mostra invece un set di prompt fisso nel Prompt Tracking, interrogato ogni giorno e mediato su più settimane. Chi tiene separate le due cose ottiene un dato corretto e una curva che mostra le variazioni in modo affidabile.