Quali pagine vengono citate da ChatGPT, dall’AI Mode e dalle AI Overviews di Google, e cosa hanno in comune? Abbiamo analizzato 96.418 URL e verificato quali raccomandazioni GEO reggono alla prova di un ampio set di dati.
- Cosa funziona: struttura per la macchina, fiducia per le persone
- Struttura: indice dei contenuti, schema Article e FAQ
- Fiducia: box autore, data di aggiornamento, fonti
- Attualità: l'anno nel title
- Nel complesso: 2,1 volte più citazioni
- Tutti i fattori in sintesi
- Cosa rende meno del previsto?
- llms.txt: nessun vantaggio misurabile
- Non tutti gli schema sono uguali
- Leggibilità: importante per le persone, neutra per l'AI
- Numero di parole: sintomo, non causa
- Piattaforme e tipi di dominio: stessi principi, pesi diversi
- Conclusione: cosa puoi mettere in pratica da domani
- Come abbiamo misurato
- FAQ: domande frequenti sullo studio sulla Citation Worthiness
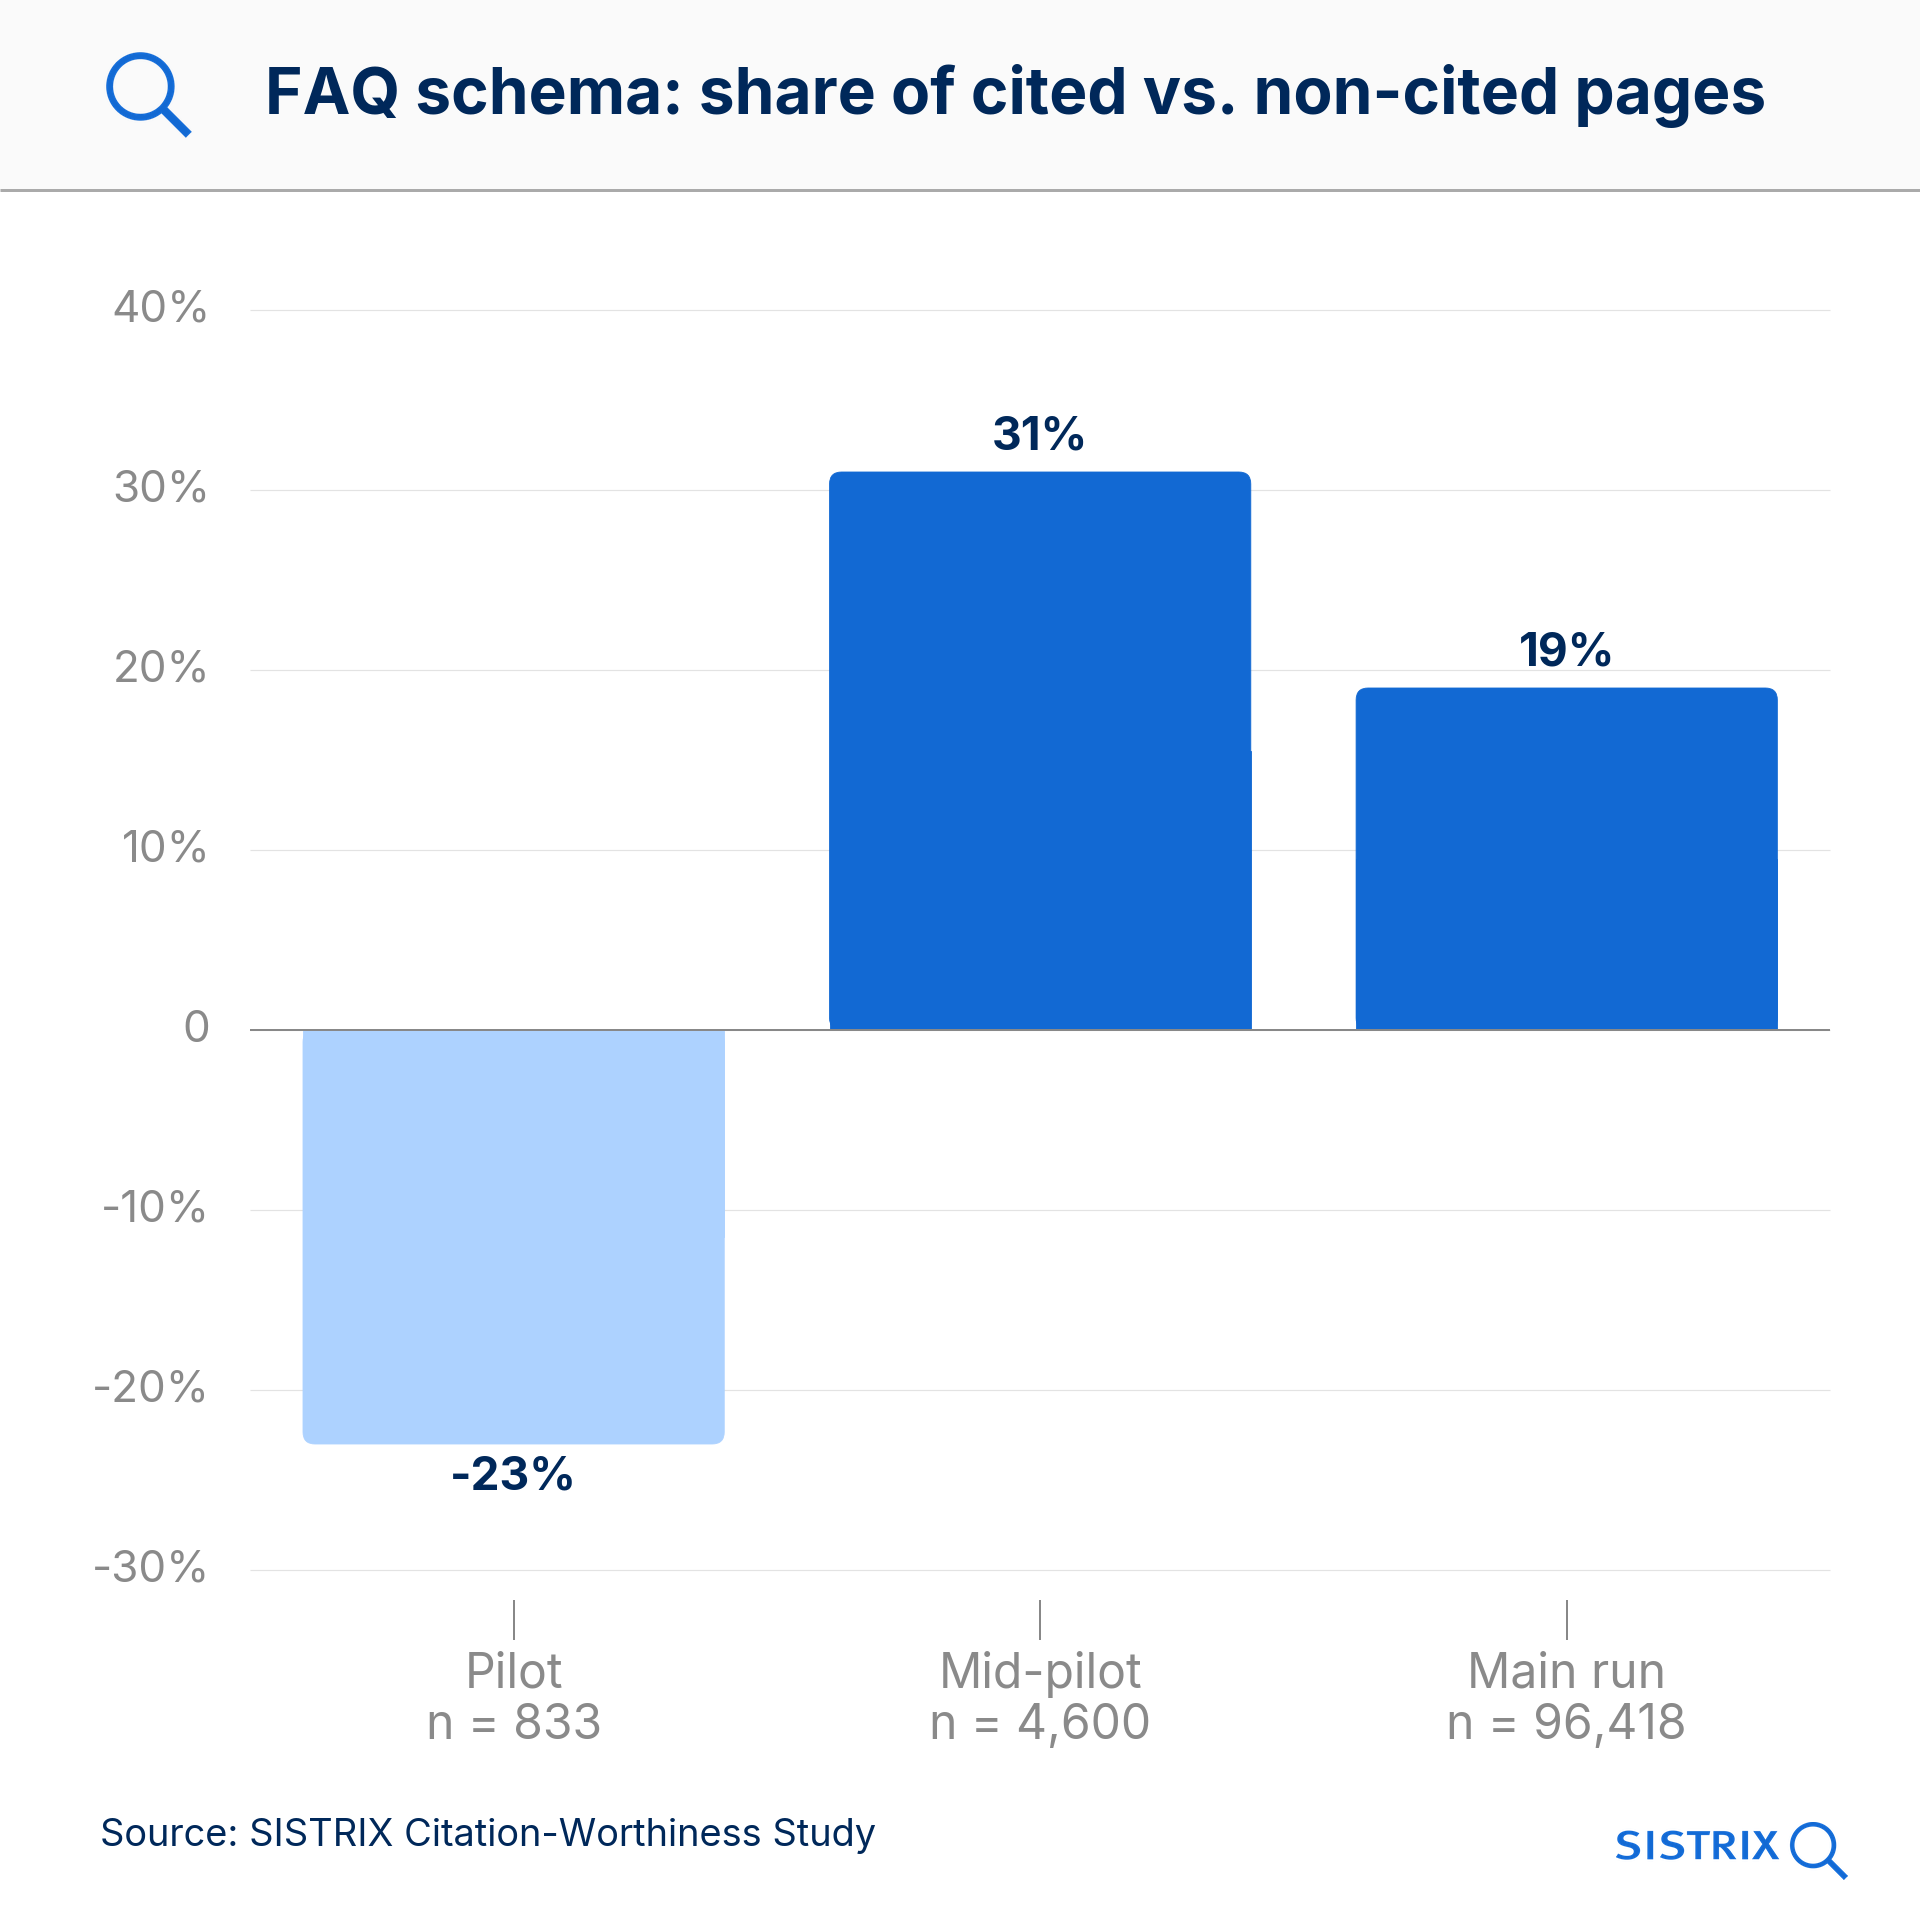
Di consigli sul GEO ormai ce ne sono a bizzeffe, di dati solidi a supporto molti meno. Molte raccomandazioni si basano su esperimenti di laboratorio, case study con poche centinaia di URL o classifiche top 100 che misurano soprattutto la forza del brand. Quanto velocemente i set di dati piccoli possano trarre in inganno lo abbiamo sperimentato noi stessi: nei nostri test, l’effetto dello schema FAQ si è completamente invertito man mano che il campione cresceva.
Per lo studio sulla Citation Worthiness abbiamo quindi esaminato una grande quantità di dati: 48.527 pagine dell’AI Index di SISTRIX per l’area DACH citate da ChatGPT, dall’AI Mode o dalle AI Overviews, ciascuna messa a confronto diretto con una pagina non citata dello stesso dominio. I risultati principali in sintesi:
TL;DR
- Una volta nel template: inserisci un indice dei contenuti, lo schema Article, un box autore con foto e, soprattutto per i contenuti editoriali, una data di aggiornamento visibile.
- Per ogni pagina: aggiungi un blocco FAQ con schema, un TL;DR, una domanda come titolo H2, una tabella e le fonti, dove il contenuto lo consente.
- A livello strategico: conosci il tuo tipo di dominio, mantieni aggiornati i contenuti e, per gli e-commerce, crea una sezione di guide.
- Cosa puoi risparmiarti: dare priorità al file llms.txt, considerare lo schema una soluzione miracolosa, allungare i testi fino a un numero di parole prestabilito e fidarti di studi con meno di 5.000 URL.
- L’effetto: le pagine che combinano molte di queste caratteristiche vengono citate 2,1 volte più spesso di quelle poco ottimizzate.
Come abbiamo misurato e quali sono i limiti dello studio lo spieghiamo più avanti.
Nota bene: questo studio si basa su dati del mercato di lingua tedesca (area DACH: Germania, Austria e Svizzera). I risultati possono variare in altri paesi e in altre lingue.
Cosa funziona: struttura per la macchina, fiducia per le persone
Quasi tutti i segnali positivi si riconducono a due principi:
- Rendere semplice l’estrazione dei contenuti per i sistemi AI, ad esempio con indice dei contenuti, schema Article e FAQ, domande come sottotitoli, tabelle ed elenchi.
- Mostrare che dietro i contenuti c’è una persona che li cura, ad esempio con box autore, data di aggiornamento e fonti.
Prima di entrare nel dettaglio delle singole caratteristiche, una breve nota su come leggere i numeri: tutti i risultati sono espressi come fattore. Un fattore di 1,7 per l’indice dei contenuti significa che, tra due pagine dello stesso dominio, quella con l’indice viene citata 1,7 volte più spesso di quella senza. Un fattore di 1,0 indica nessuna differenza, mentre i valori inferiori sono associati a meno citazioni.
Struttura: indice dei contenuti, schema Article e FAQ
Nessun segnale strutturale è associato a più citazioni dell’indice dei contenuti: le pagine con un indice visibile e link di ancoraggio vengono citate 1,7 volte più spesso. Eppure solo il 14% delle pagine ne ha uno. Le pagine con schema Article vengono citate 1,6 volte più spesso, e nella maggior parte dei CMS il markup si attiva con una semplice impostazione. Le pagine con schema FAQPage vengono citate 1,5 volte più spesso, su tutte e tre le piattaforme e per tutti i tipi di dominio tranne le enciclopedie, nonostante Google abbia eliminato i rich result FAQ. Il presupposto sono domande vere e non FAQ di facciata.
A questi si aggiungono segnali strutturali minori: almeno cinque titoli H2 (1,6), tabelle con riga di intestazione (1,5), almeno dieci elenchi puntati per pagina (1,5), almeno una domanda come titolo H2 (1,4) e un riassunto TL;DR all’inizio (1,3). Il valore relativo al numero di titoli H2 va però letto con cautela, perché i testi più lunghi hanno quasi automaticamente più sottotitoli. Diverso il discorso per le domande come titolo, il cui effetto non dipende dalla lunghezza del testo.
Fiducia: box autore, data di aggiornamento, fonti
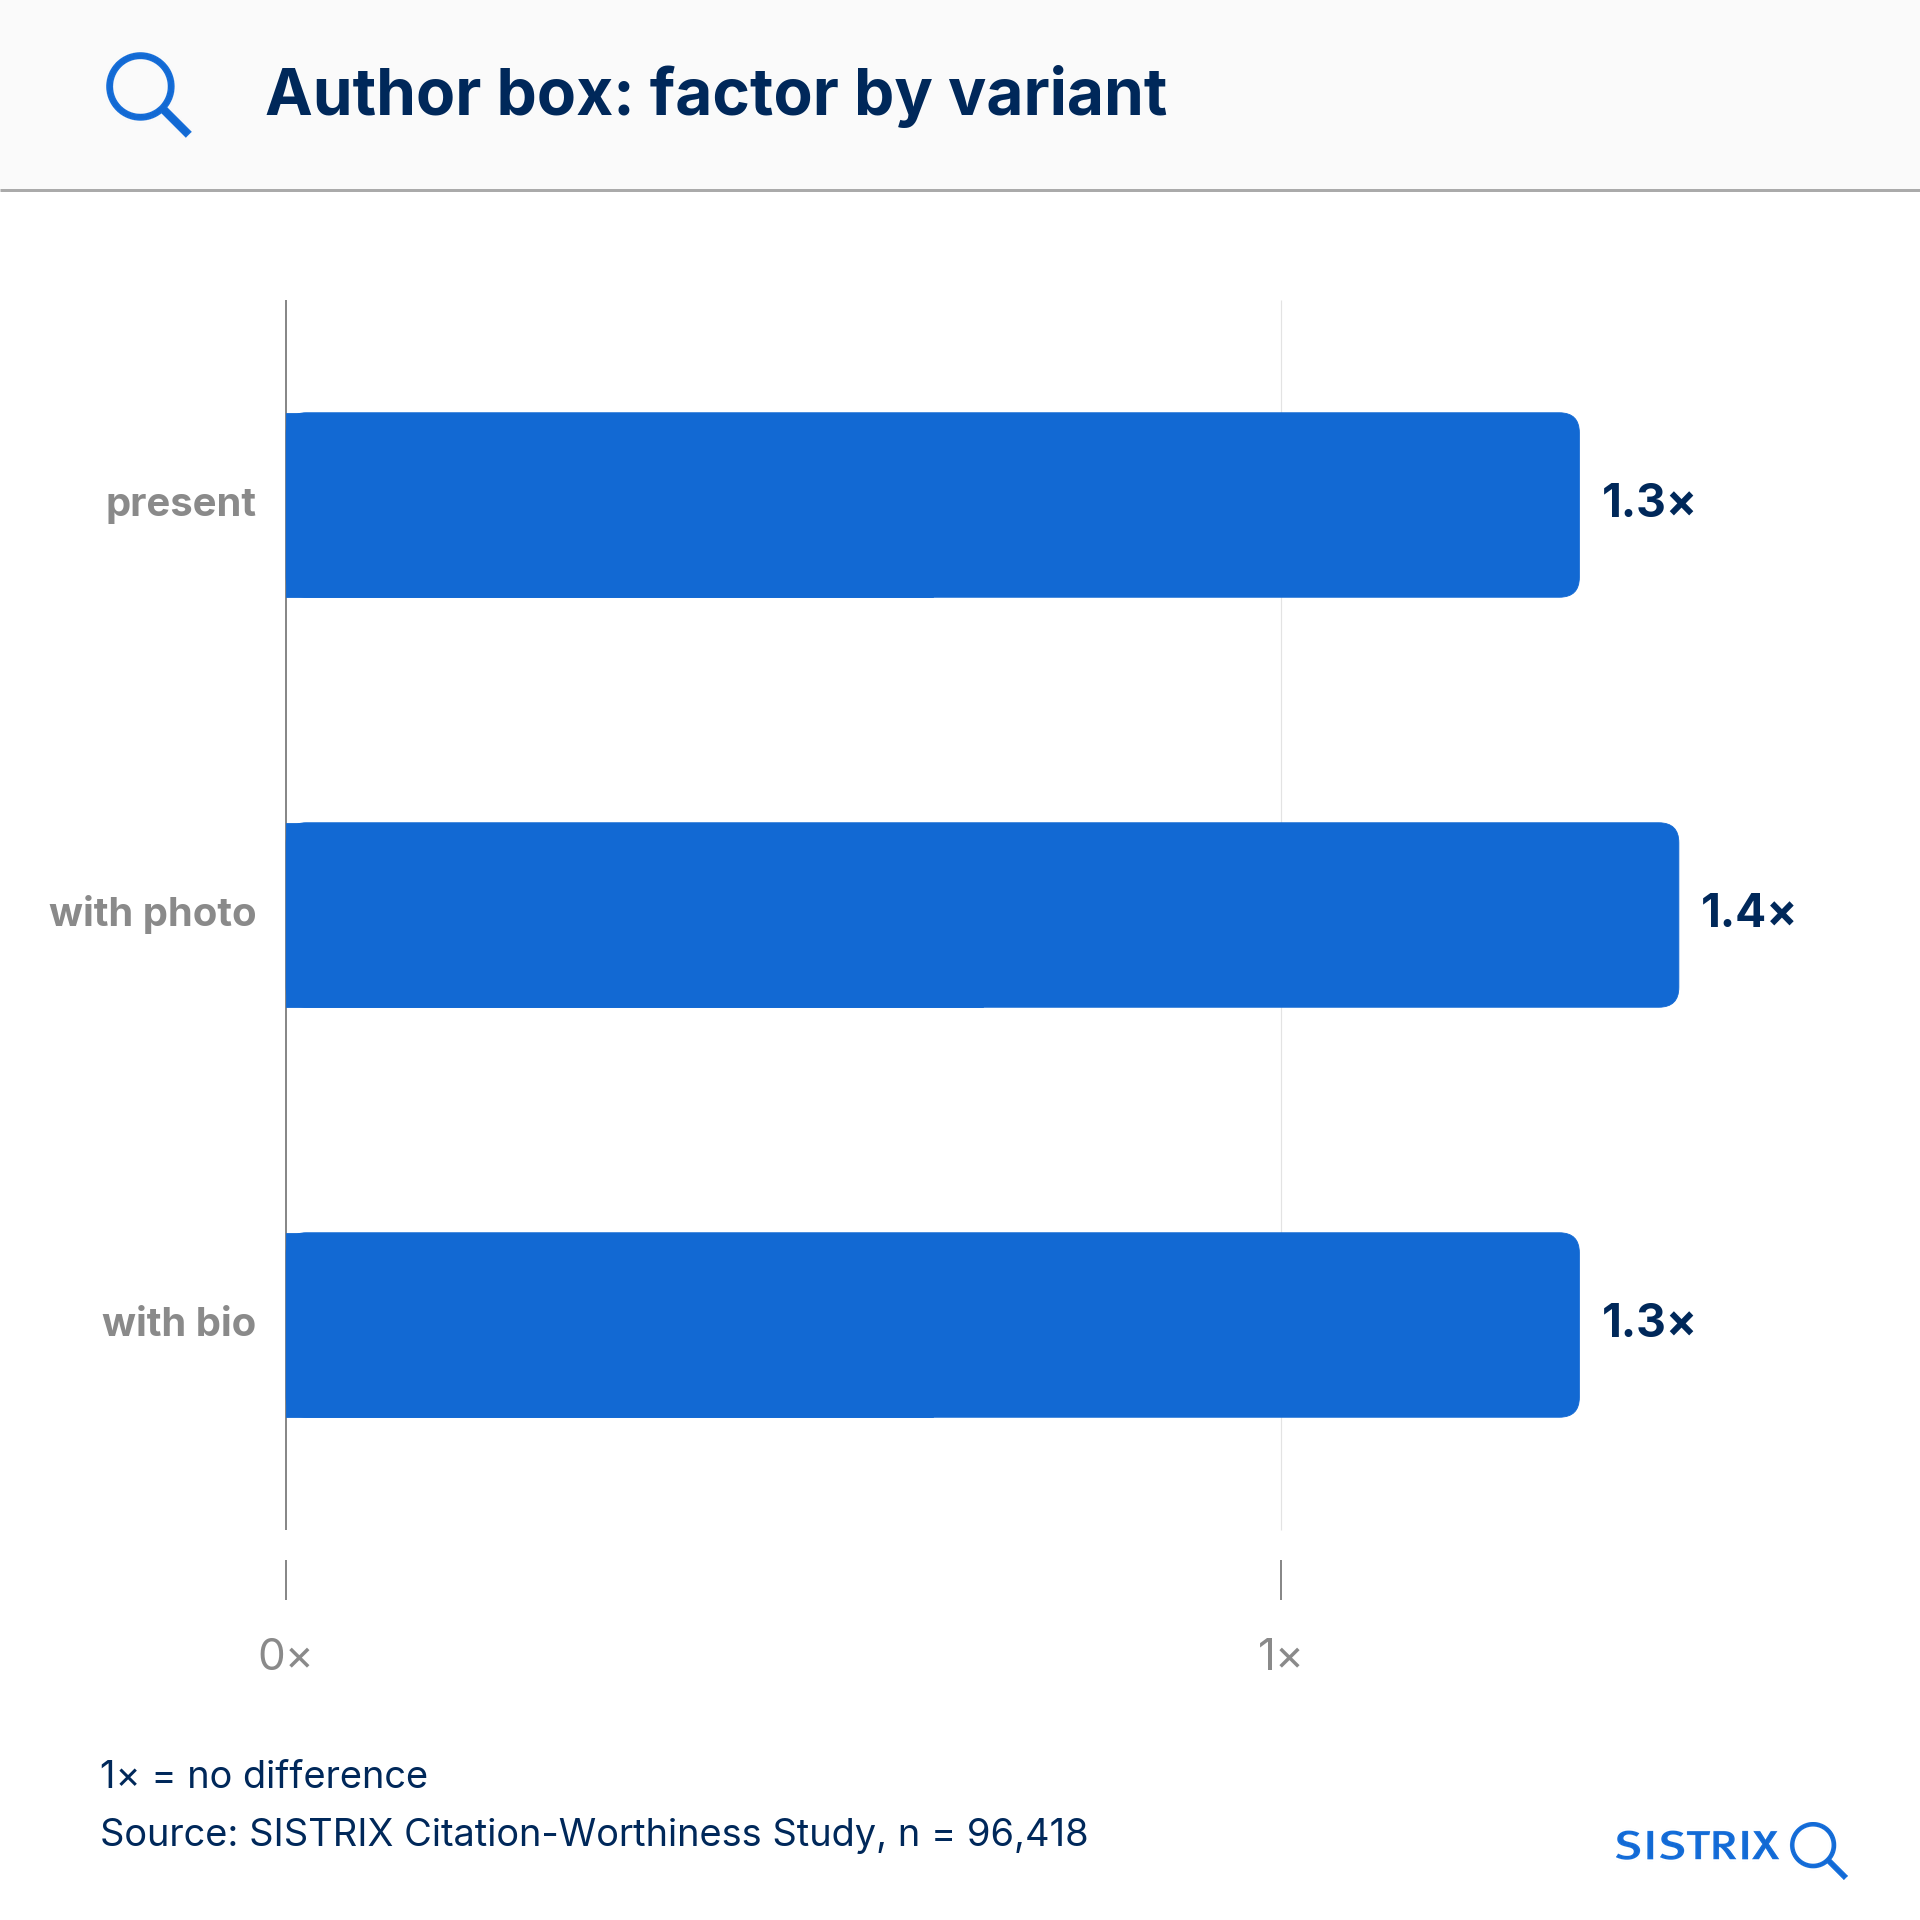
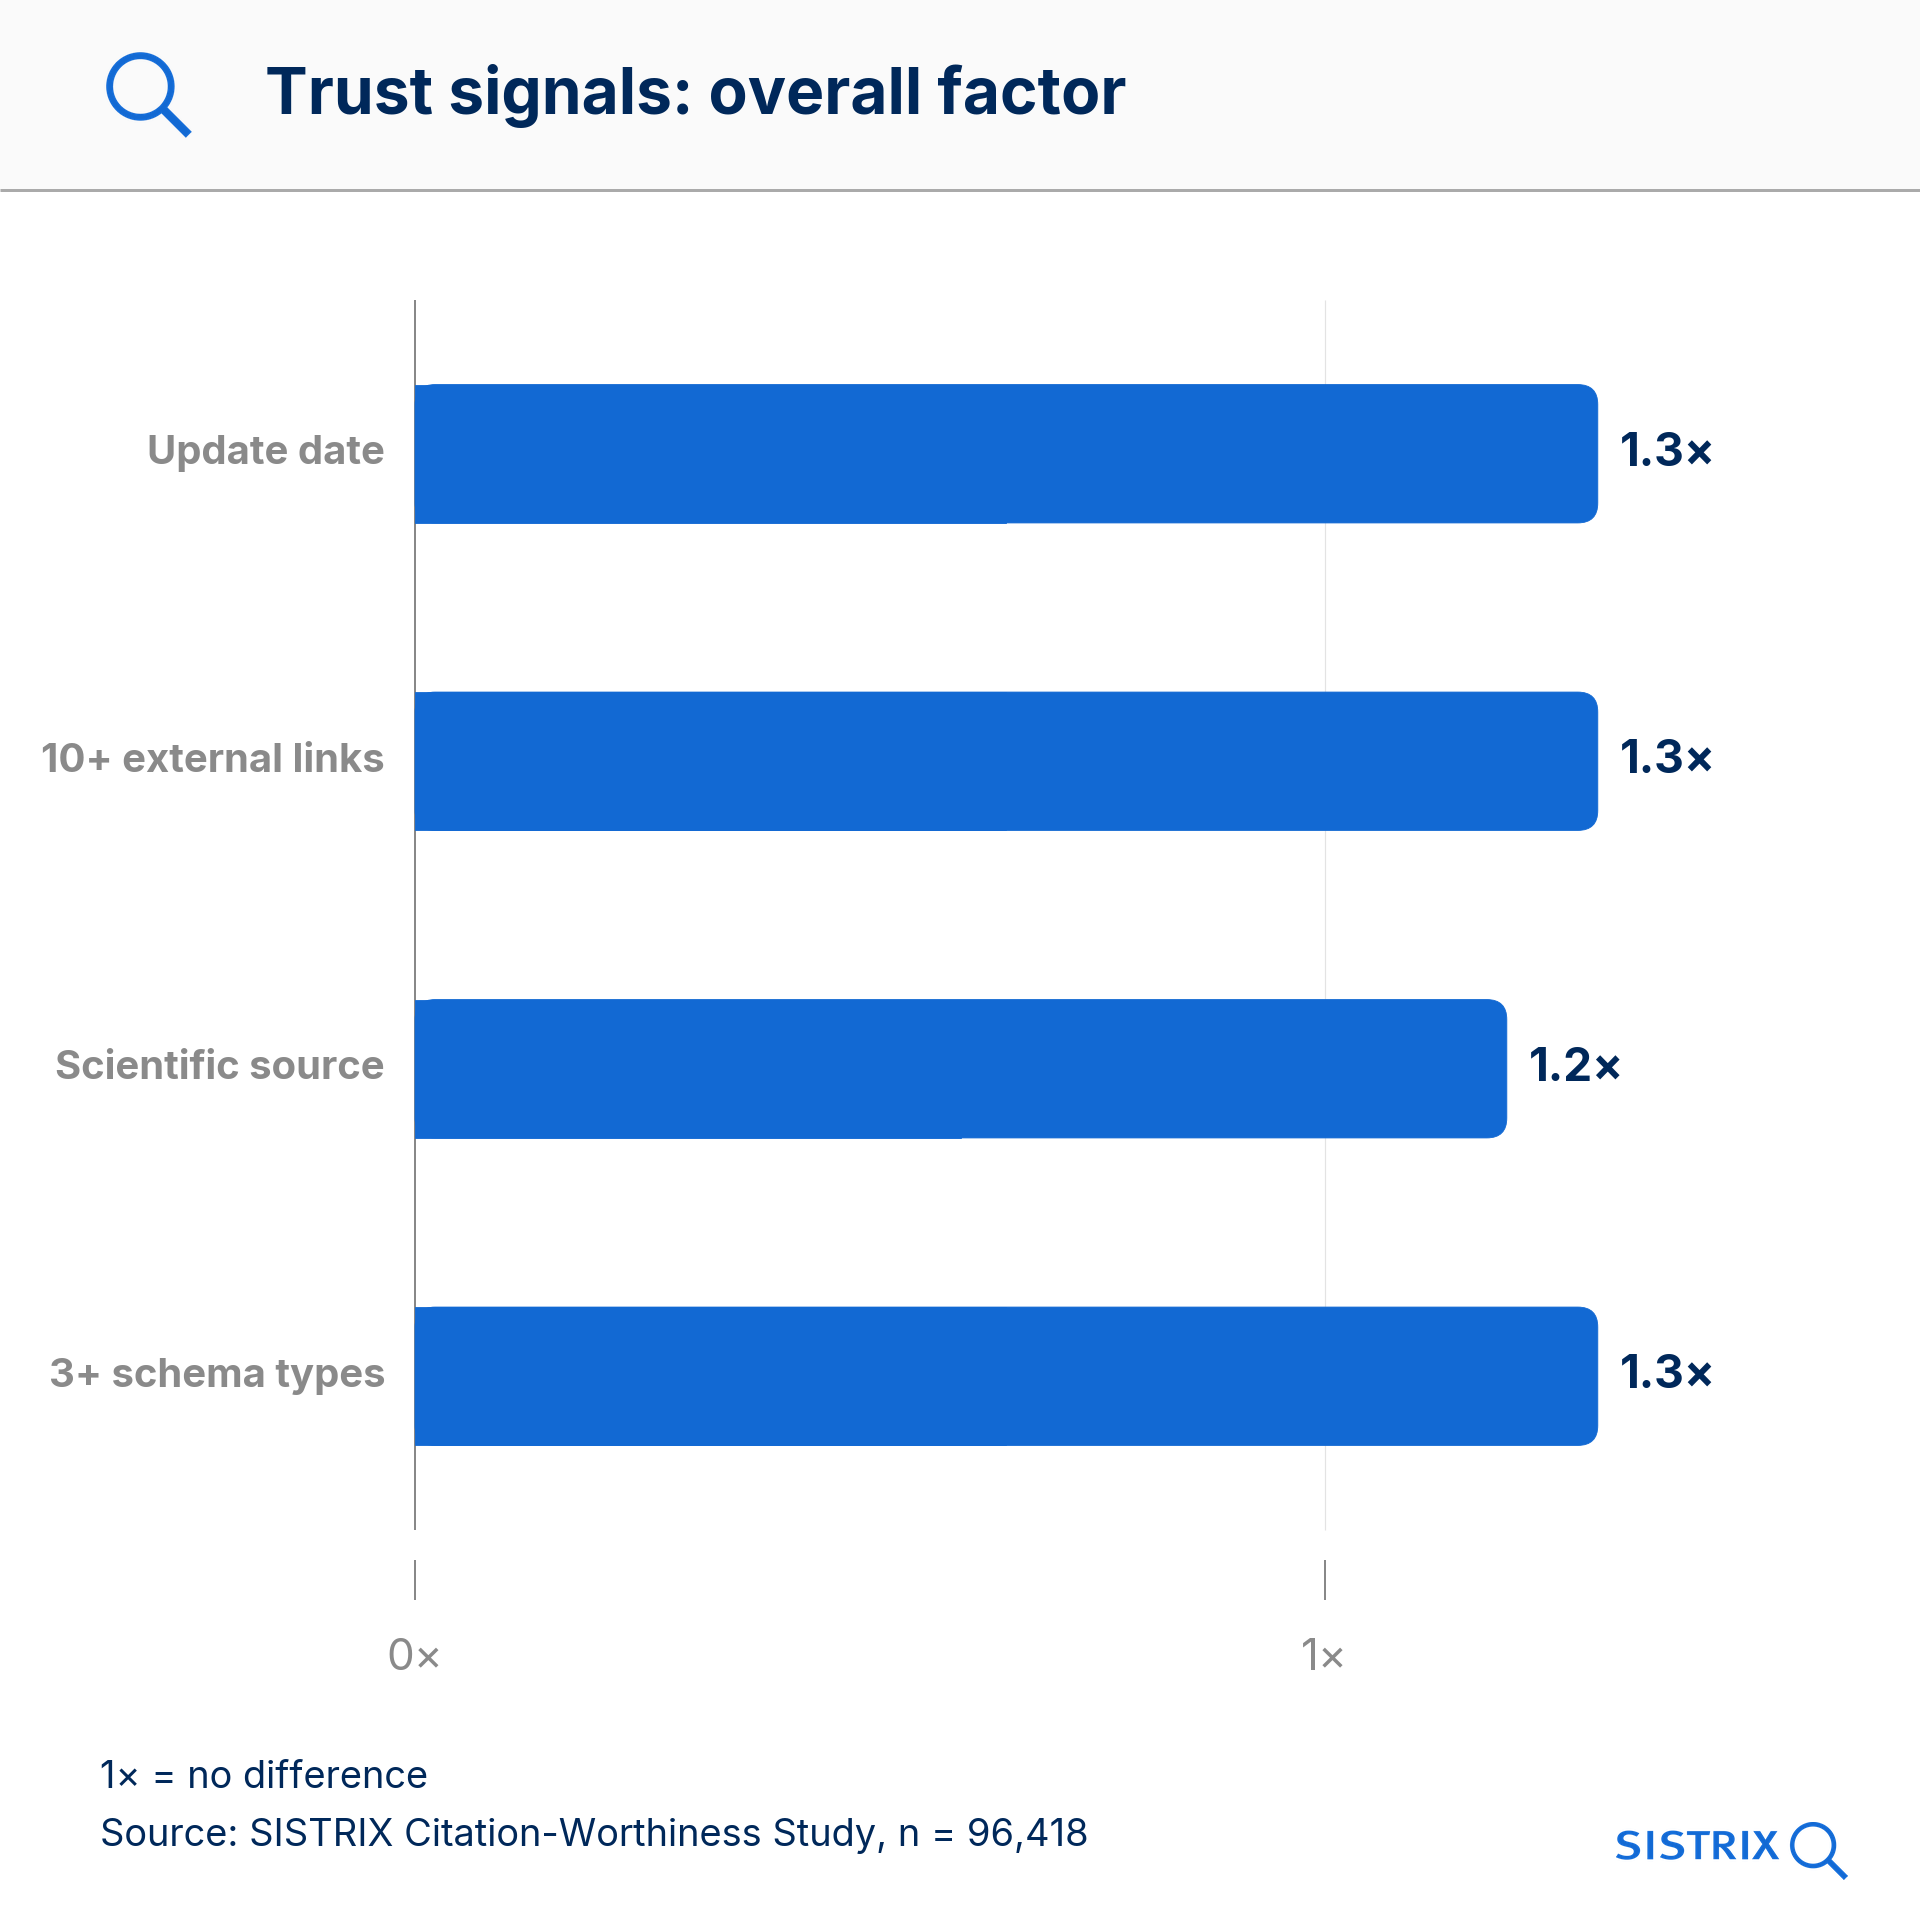
Le pagine con box autore e foto vengono citate 1,4 volte più spesso. Non serve molto: nome, foto, due frasi sulle competenze dell’autore e schema Person. Le pagine con una data di aggiornamento visibile, almeno dieci link esterni o almeno tre diversi tipi di dati strutturati vengono citate ciascuna 1,3 volte più spesso. Solo il 5% delle pagine mostra però una data di aggiornamento, e la sua efficacia dipende dal tipo di dominio. Ne parliamo più avanti.
Attualità: l’anno nel title
Il valore più alto dello studio lo raggiunge l’anno corrente nel title: le pagine con 2025 o 2026 nel title vengono citate 2,7 volte più spesso, mentre quelle con solo un anno precedente si fermano a un fattore di 0,7. Non si tratta però di un trucco sul title. L’anno è un indicatore di contenuti creati o aggiornati di recente. Dai dati non si può dedurre se basti modificare solo l’anno. Inoltre, questa caratteristica non faceva parte dell’analisi pianificata inizialmente ma è stata aggiunta in un secondo momento. Il valore è quindi più un primo indizio che un risultato consolidato.
Nel complesso: 2,1 volte più citazioni
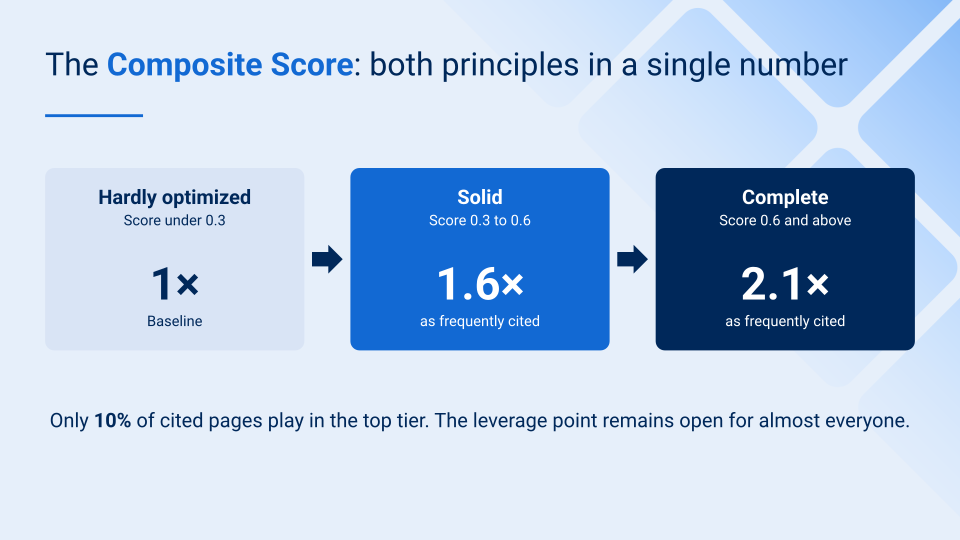
Singolarmente, la maggior parte dei segnali ha un effetto moderato, ma insieme fanno una differenza netta. Per misurarlo abbiamo creato un punteggio complessivo a partire da undici delle caratteristiche. Le pagine che ne soddisfano molte vengono citate 2,1 volte più spesso delle pagine poco ottimizzate, quelle nella fascia media 1,6 volte. Solo il 10% delle pagine citate soddisfa già molte di queste caratteristiche, quindi quasi tutte hanno ancora margini di miglioramento.
Tutti i fattori in sintesi
| Feature | Citation factor |
|---|---|
| Current year in the title* | 2.7 |
| Table of contents | 1.7 |
| Article schema | 1.6 |
| At least five H2 headings | 1.6 |
| FAQPage schema | 1.5 |
| Table with a header row | 1.5 |
| Bullet lists (ten or more per page) | 1.5 |
| At least 1,000 words | 1.5 |
| Author box with photo | 1.4 |
| At least one question as an H2 | 1.4 |
| H1 with at least five words* | 1.4 |
| Visible last-updated date | 1.3 |
| At least three schema types | 1.3 |
| At least ten external links | 1.3 |
| TL;DR at the beginning | 1.3 |
| Title phrased as a question* | 1.3 |
| Title with at least 45 characters* | 1.3 |
| Meta description | 1.2 |
| Scientific source | 1.2 |
| Numbered lists | 1.2 |
| Expandable details blocks | 1.2 |
| At least 100 internal links | 1.2 |
| Title with a colon* | 1.2 |
| Images in the main content | 1.1 |
| Good readability (Flesch index) | 1.03 (not significant) |
| Breadcrumb, HowTo and QAPage schema | 1.0 |
| Title consisting only of the H1 plus a brand suffix* | 0.9 |
| Product schema | 0.8 |
| Only an older year in the title* | 0.7 |
| Recipe schema | 0.1 |
Un fattore di 1,0 indica nessuna differenza. * Le caratteristiche relative a title e H1 sono state analizzate in un secondo momento e vanno intese come primi indizi.
Cosa rende meno del previsto?
llms.txt: nessun vantaggio misurabile
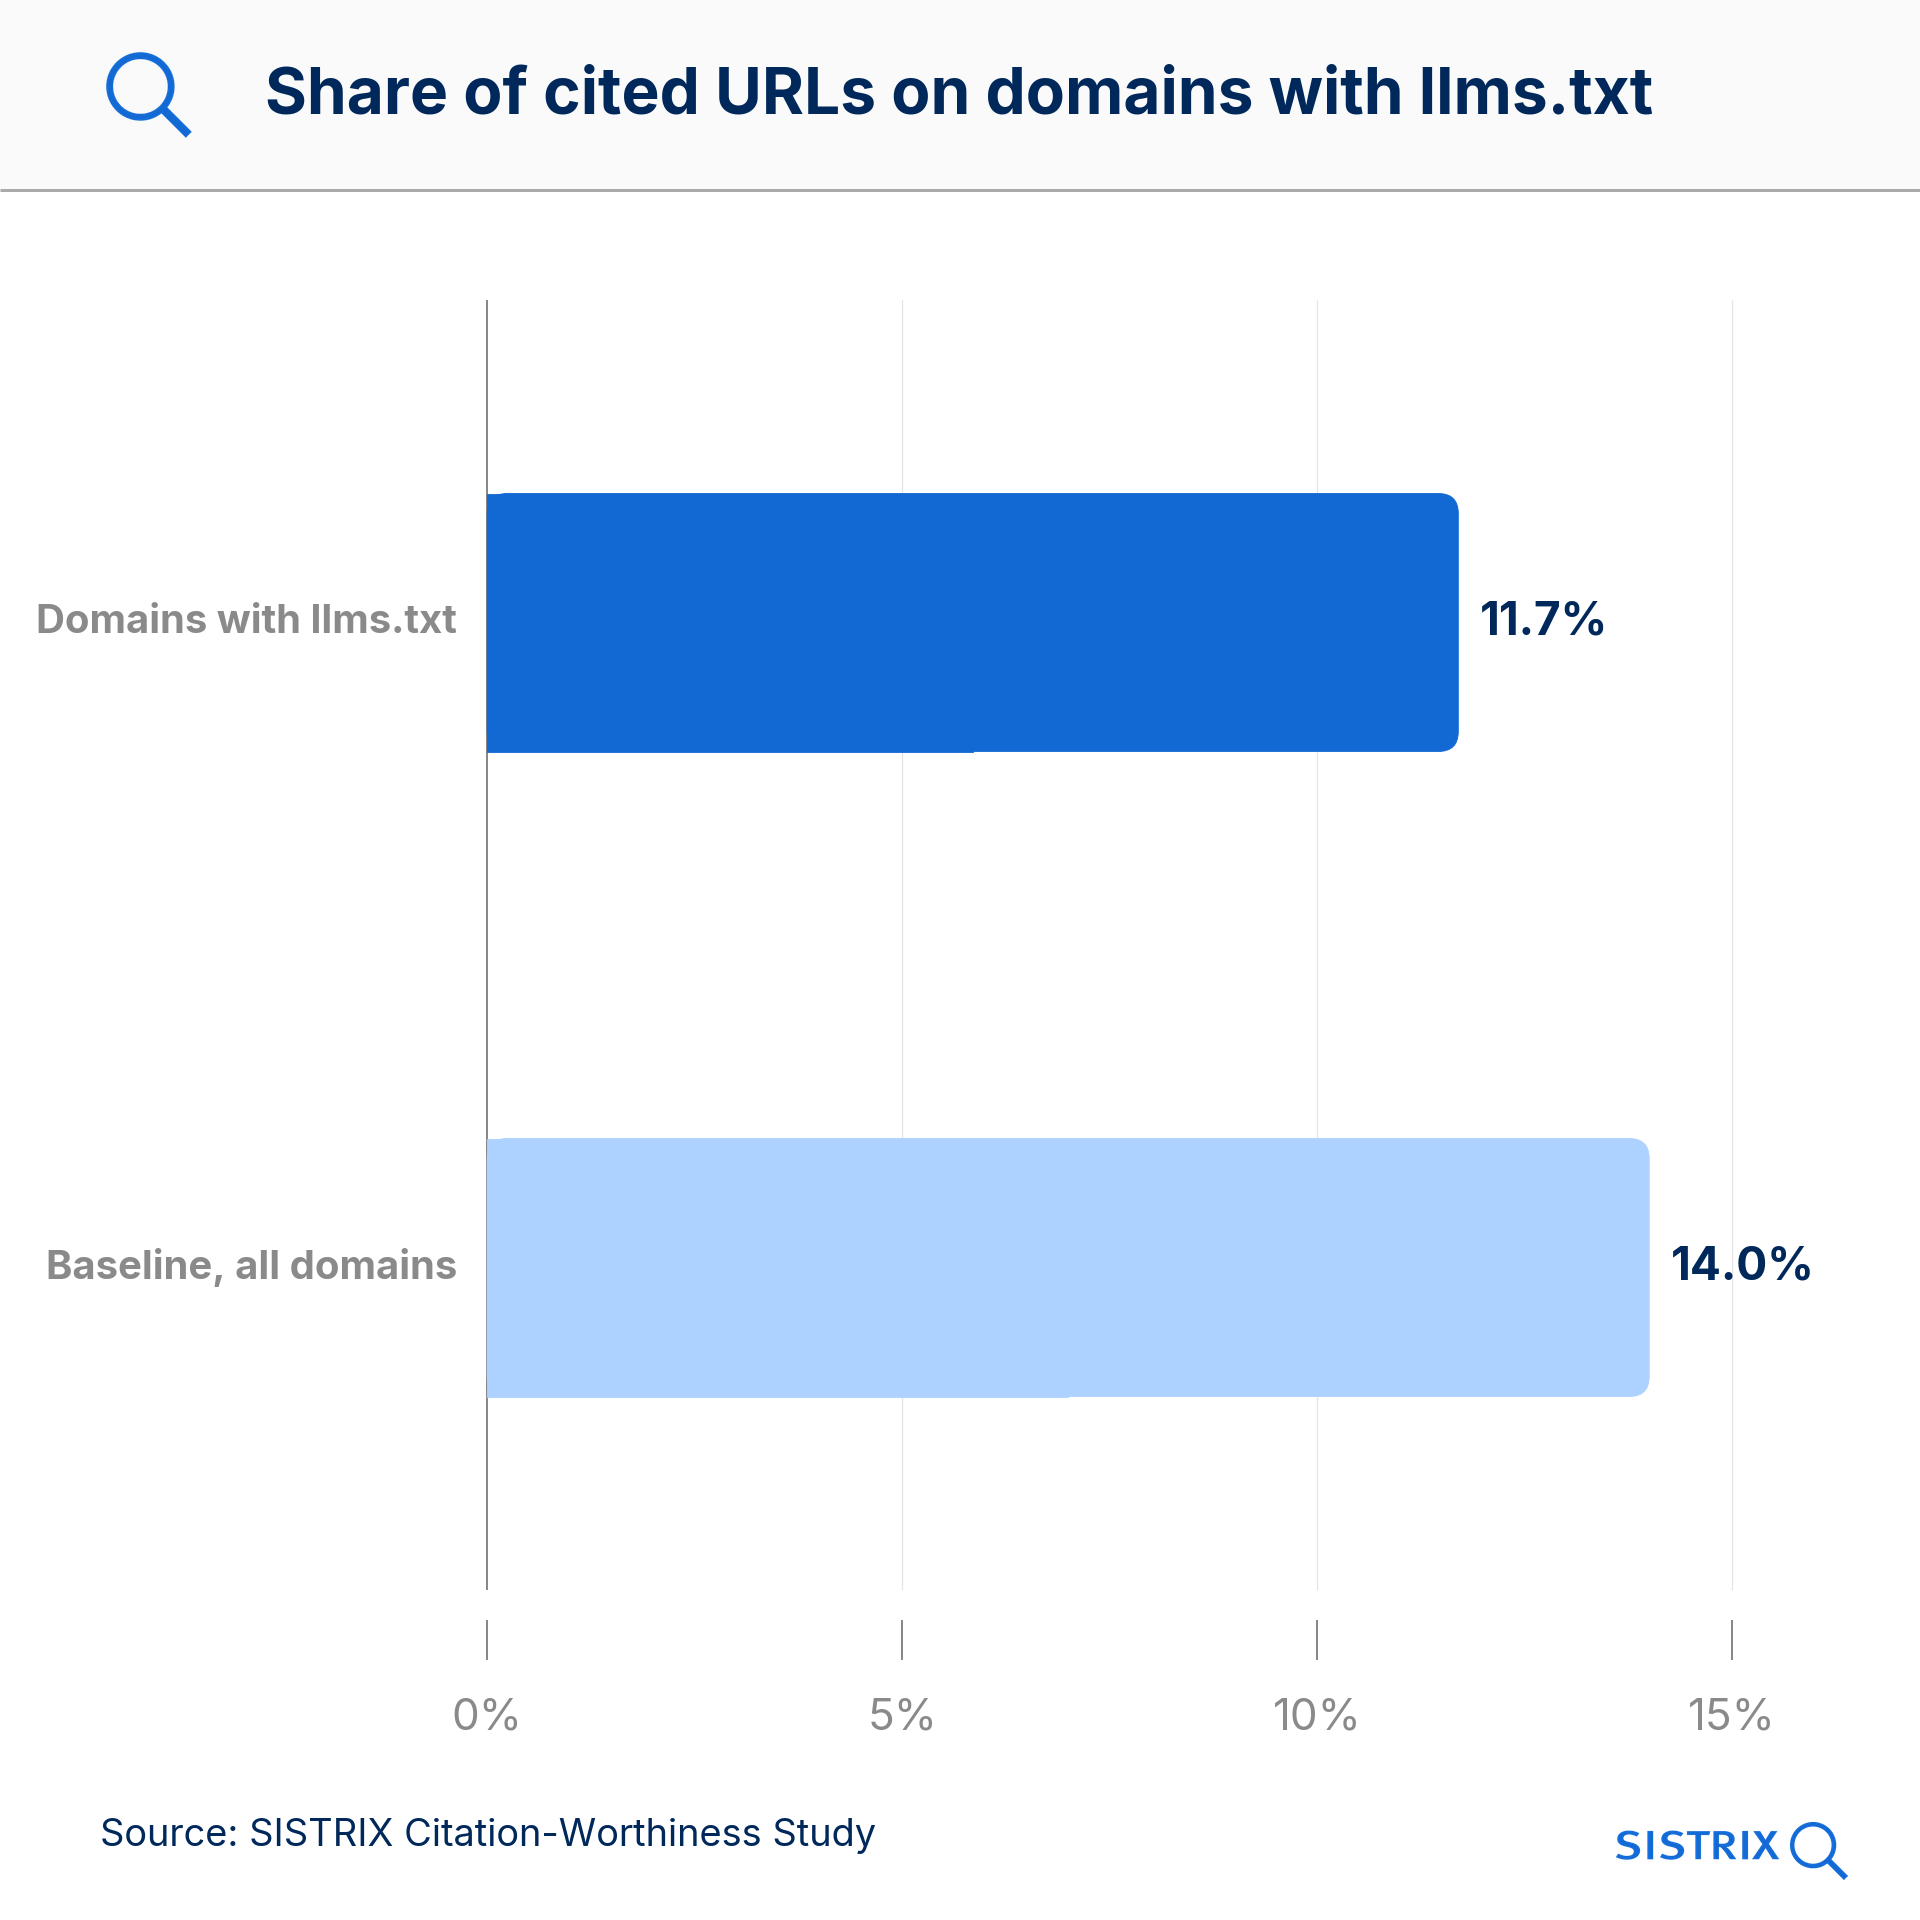
Pochi temi GEO sono stati discussi così a lungo quest’anno come il file llms.txt. Allo stato attuale, non si rileva alcun effetto misurabile sulle citazioni AI. Poiché il file vale per l’intero dominio, in questo caso abbiamo fatto un’eccezione e confrontato i domini tra loro: di tutti gli URL citati, l’11,7% proviene da domini con llms.txt, mentre sull’insieme dei domini la loro quota è del 14,0%. I domini con llms.txt sono quindi, semmai, meno rappresentati tra quelli citati. Questo non permette comunque di concludere che il file sia dannoso, perché i domini confrontati differiscono anche per molti altri aspetti. Di certo, però, non dovrebbe essere una priorità.
Non tutti gli schema sono uguali
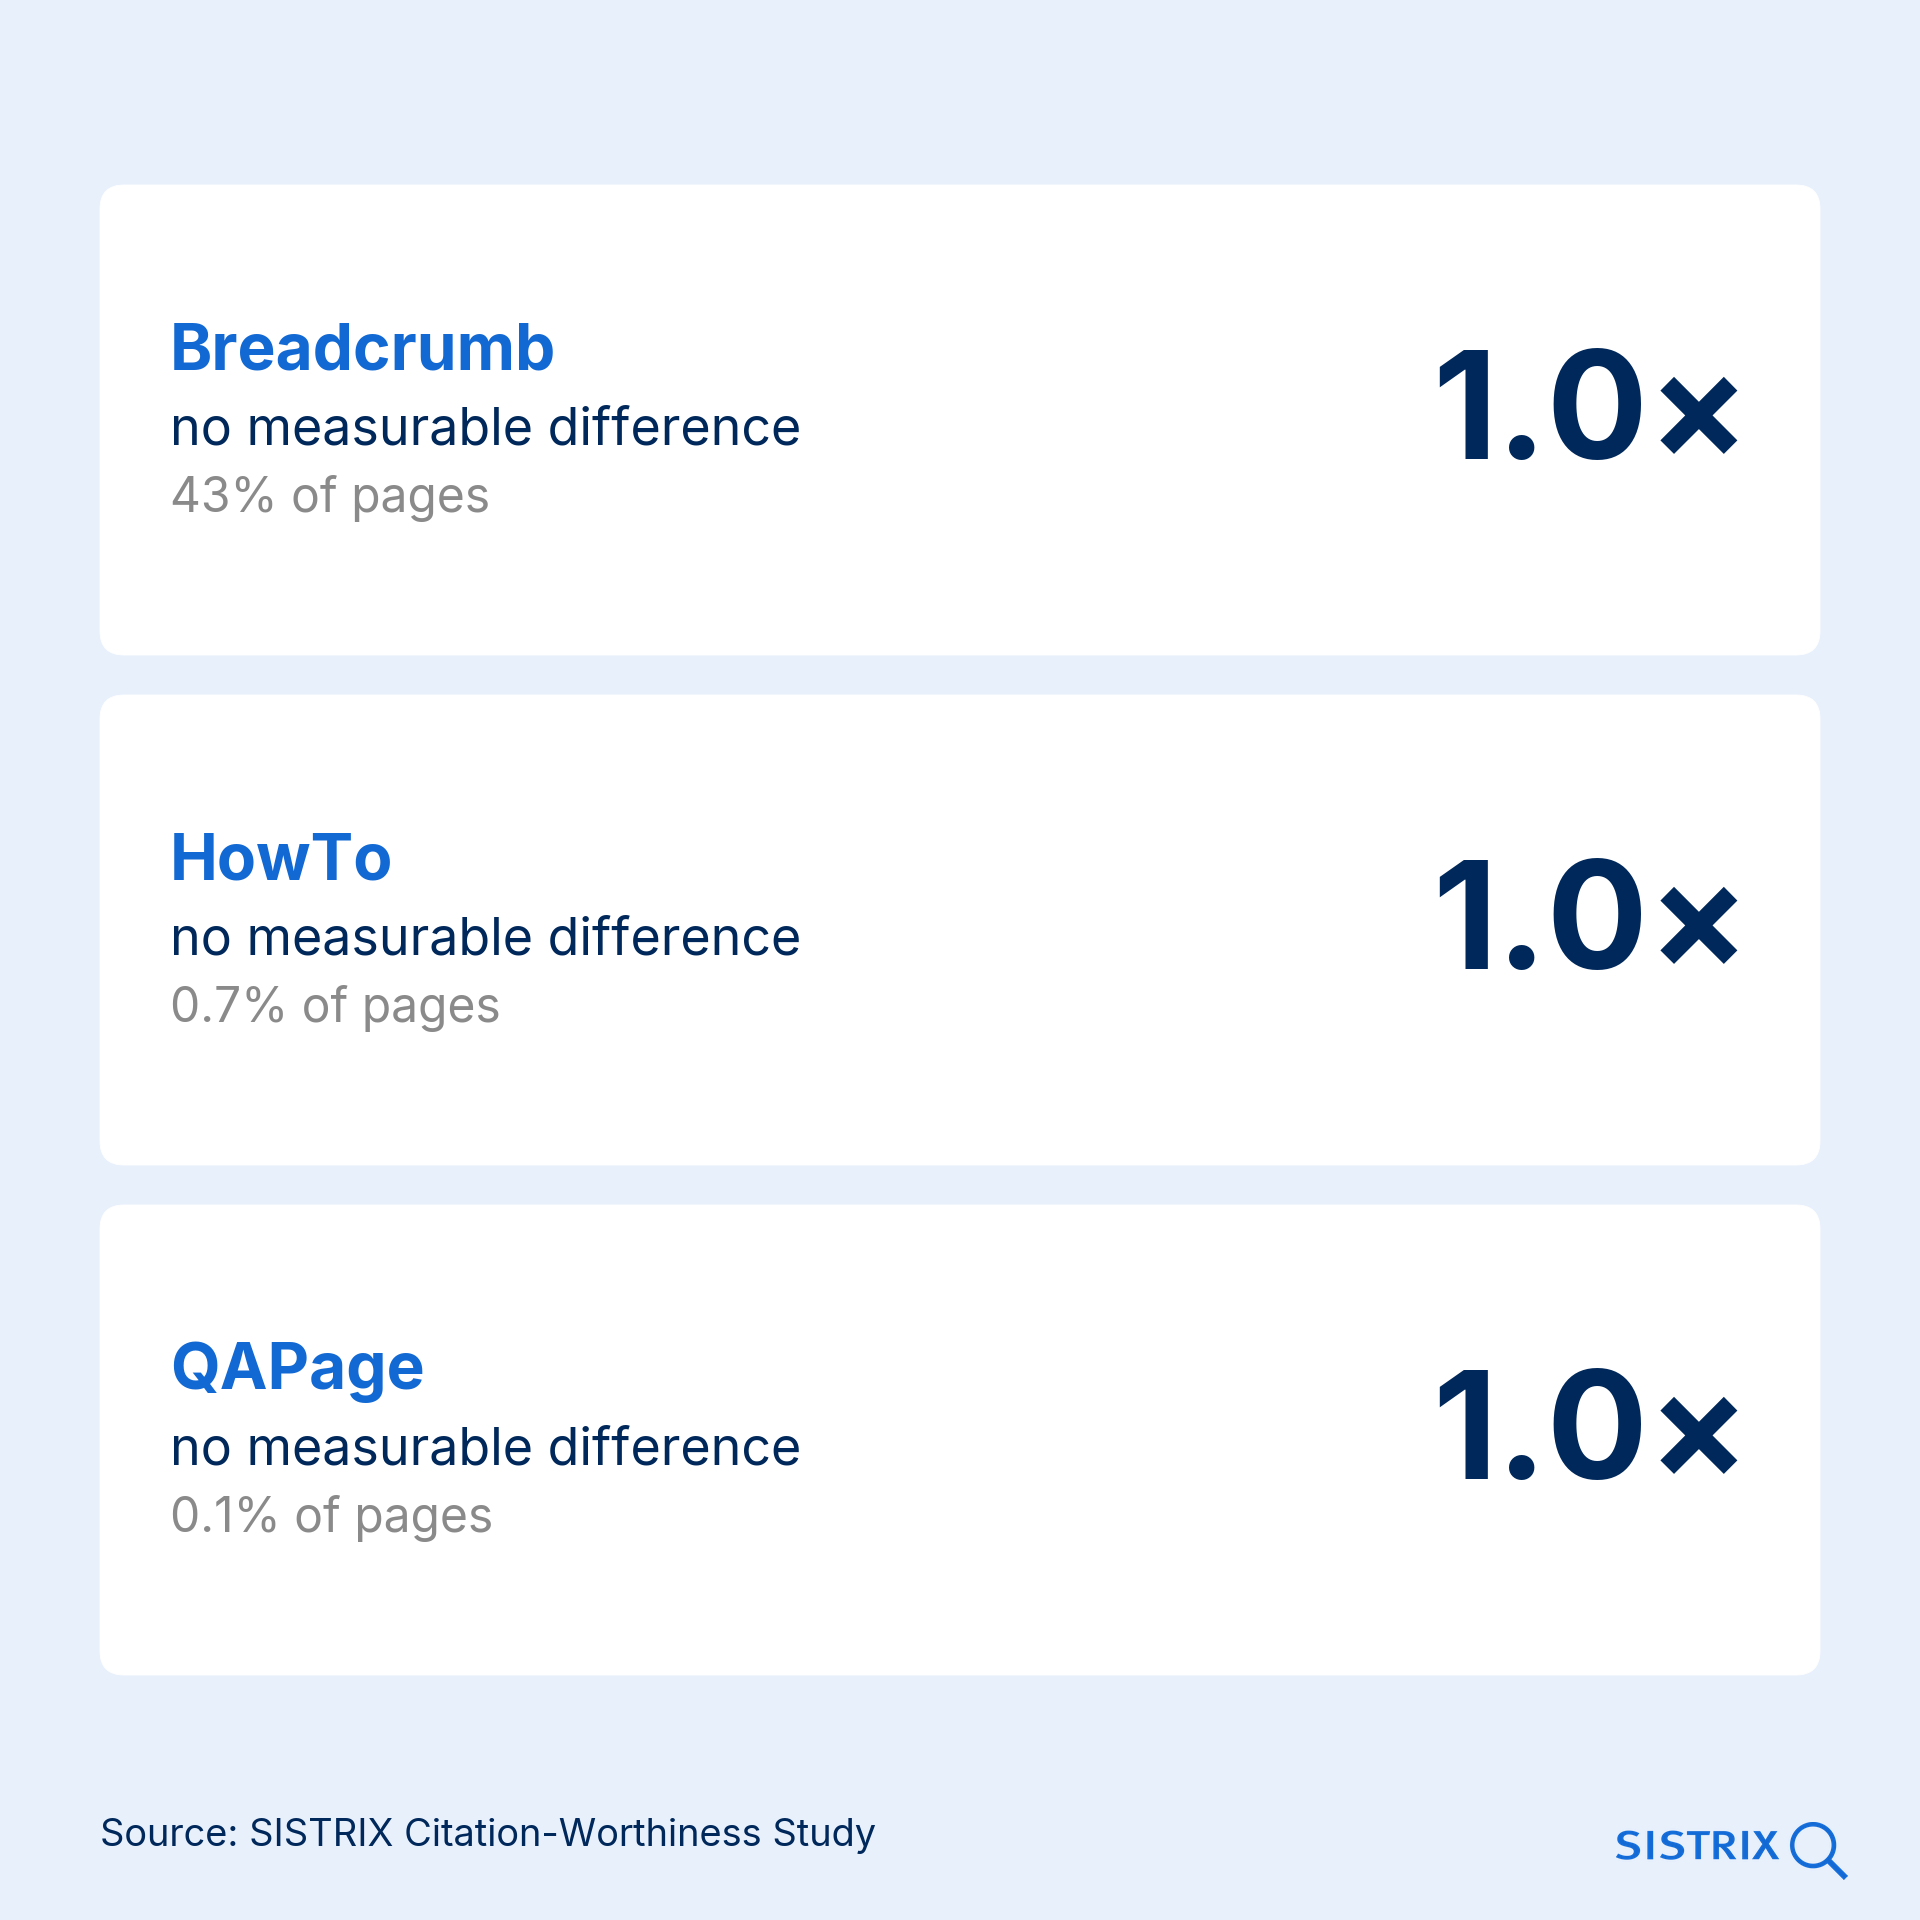
I dati strutturati sono considerati l’arma miracolosa del GEO. I markup Breadcrumb, HowTo e QAPage, però, non mostrano alcuna differenza misurabile (fattore 1,0), nonostante i breadcrumb siano presenti sul 43% delle pagine. Per la ricerca classica restano comunque utili.
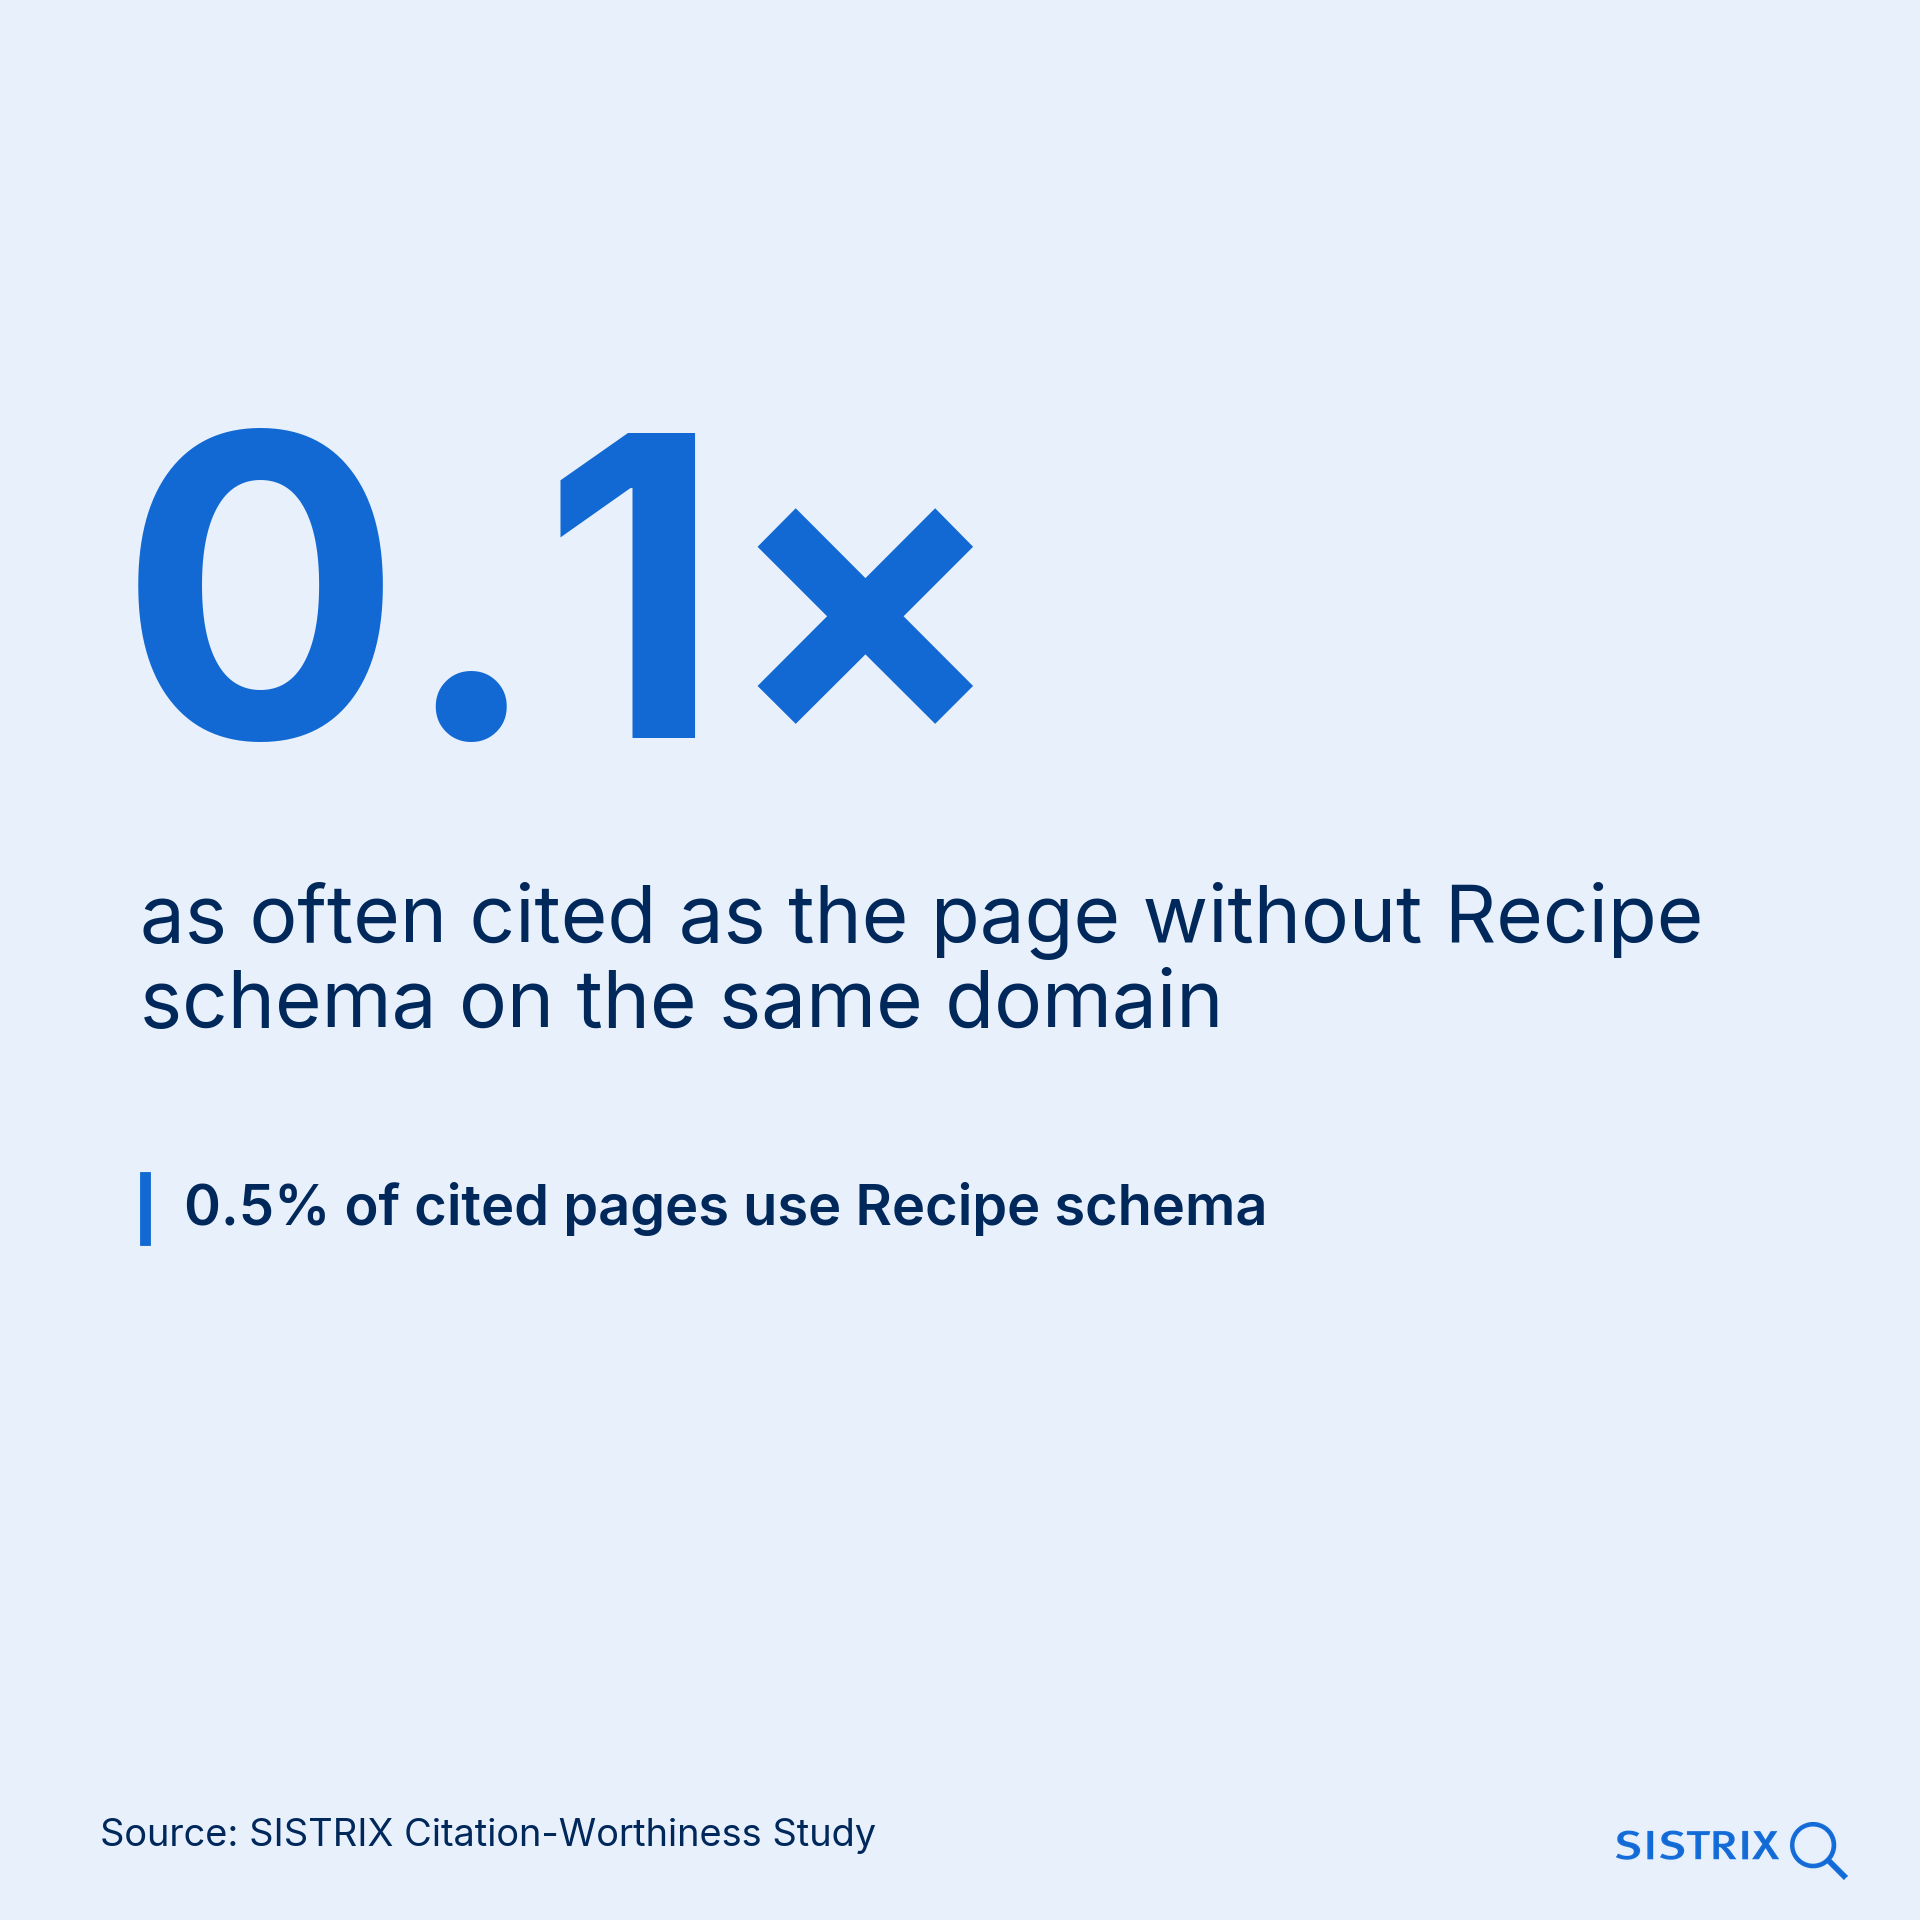
Lo schema Recipe si distingue addirittura in negativo: le pagine con questo markup si fermano a un fattore di appena 0,1, e ciò vale per tutti i settori per cui disponiamo di dati sufficienti. La nostra ipotesi, non ancora convalidata: i sistemi AI preferiscono rimandare a una pagina tematica piuttosto che alla singola ricetta. Per i publisher del settore food conviene quindi creare pagine tematiche e di panoramica con schema Article come destinazione delle citazioni.
Lo schema Product (0,8, oppure 0,5 nelle AI Overviews) e l’hreflang sono associati a un numero leggermente inferiore di citazioni. Non è una leva, ma nemmeno un motivo di preoccupazione: entrambi i markup hanno una loro funzione al di fuori del GEO e vanno mantenuti.
Leggibilità: importante per le persone, neutra per l’AI
I testi comprensibili restano importanti per i lettori. Un buon punteggio nell’indice di Flesch, che misura la leggibilità di un testo, non rende però una pagina più citabile. Il fattore di 1,03 non è significativo.
Numero di parole: sintomo, non causa
È vero che le pagine con almeno 1.000 parole vengono citate 1,5 volte più spesso. Ma i testi più lunghi hanno di solito anche più titoli, tabelle ed elenchi, quindi il valore relativo alla lunghezza riflette soprattutto una struttura migliore. Trattare gli argomenti in modo completo, sì. Scrivere per raggiungere un numero di parole, no.
Piattaforme e tipi di dominio: stessi principi, pesi diversi
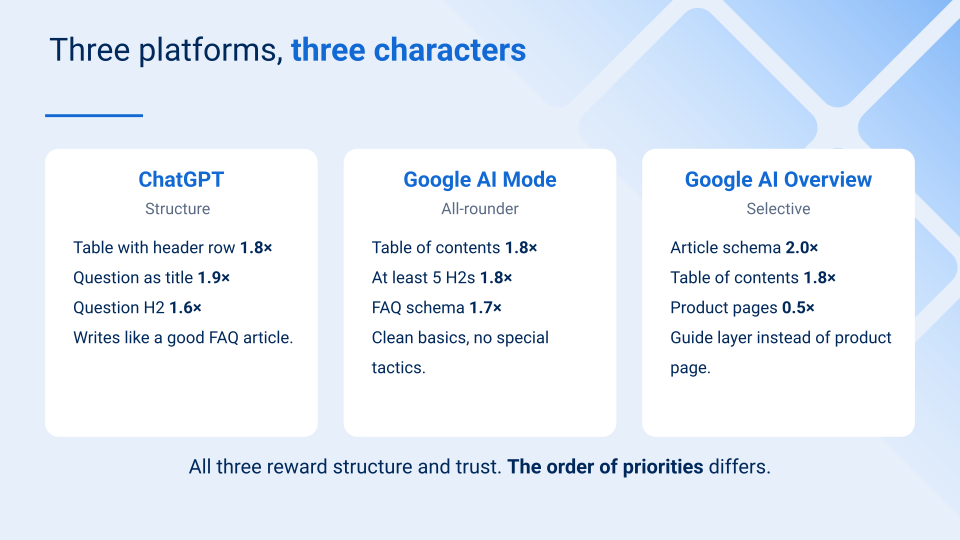
Tutte e tre le piattaforme premiano struttura e fiducia, ma con pesi diversi. In partenza ci aspettavamo che le AI Overviews reagissero più fortemente alle pagine ben ottimizzate. In realtà le tre piattaforme sono molto vicine, con ChatGPT di poco in testa e le AI Overviews subito dietro. Un’ipotesi in meno.
- ChatGPT ama la struttura costruita attorno alle domande: le pagine con un title formulato come domanda vengono citate 1,9 volte più spesso, quelle con tabelle con riga di intestazione 1,8 volte e quelle con domande come titoli H2 1,6 volte. In parole semplici, ChatGPT cita volentieri ciò che è strutturato come un buon articolo di FAQ.
- L’AI Mode è il tuttofare. Nessuna singola caratteristica spicca, e a ripagare di più sono le basi fatte bene: le pagine con indice dei contenuti o con almeno cinque titoli H2 vengono citate ciascuna 1,8 volte più spesso. Qui non servono tattiche particolari.
- Le AI Overviews sono selettive: le pagine con schema Article vengono citate il doppio (2,0), le pagine prodotto solo la metà (0,5). A essere citati sono soprattutto i contenuti informativi, meno le pagine orientate alla vendita.
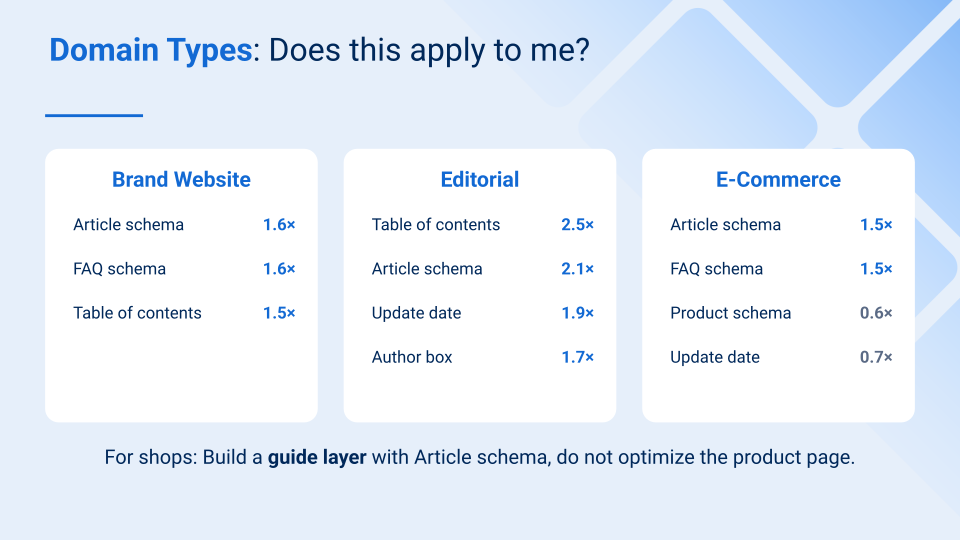
Quali caratteristiche siano più fortemente associate alle citazioni dipende anche dal tipo di sito. Per i siti di brand si tratta soprattutto degli schema Article e FAQ (1,6 ciascuno). Nei siti editoriali, le pagine con indice dei contenuti vengono citate 2,5 volte più spesso e quelle con data di aggiornamento 1,9 volte. Per gli e-commerce vale il contrario: qui una data di aggiornamento visibile è associata a meno citazioni (0,7), così come lo schema Product (0,6). Per gli shop, una sezione di guide con schema Article è quindi più promettente dell’ottimizzazione delle pagine prodotto. Lo schema Product mostra con particolare chiarezza quanto conti il tipo di sito: per i fornitori SaaS, le pagine che lo utilizzano vengono citate 1,7 volte più spesso, mentre per i siti istituzionali il fattore scende a 0,1. Infine, per le enciclopedie, le ottimizzazioni nel loro insieme non mostrano alcun effetto.
Conclusione: cosa puoi mettere in pratica da domani
Gli studi piccoli portano facilmente fuori strada, e i confronti tra interi domini misurano soprattutto la forza del brand. All’interno dello stesso dominio, invece, il quadro è chiaro: quale pagina viene citata dipende in modo misurabile dalle caratteristiche onpage. E ciò che funziona segue due principi: struttura per la macchina, fiducia per le persone. In pratica, il tutto si può riassumere in un self-audit in undici punti:
- Su ogni pagina: indice dei contenuti (1,7), schema Article (1,6), struttura H2 chiara (1,6), box autore con foto (1,4).
- Se pertinente al contenuto: blocco FAQ con schema (1,5), tabella con riga di intestazione (1,5), TL;DR all’inizio (1,3), fonti linkate (1,3), data di aggiornamento (1,3, soprattutto per i contenuti editoriali). Nulla di tutto questo va inserito in modo artificiale.
- Piccolo ma misurabile: meta description (1,2), più tipi di dati strutturati (1,3).
Quali pagine del tuo dominio vengono già citate da ChatGPT, dall’AI Mode e dalle AI Overviews puoi verificarlo in SISTRIX.
E se vuoi fare una cosa sola: struttura.
Come abbiamo misurato
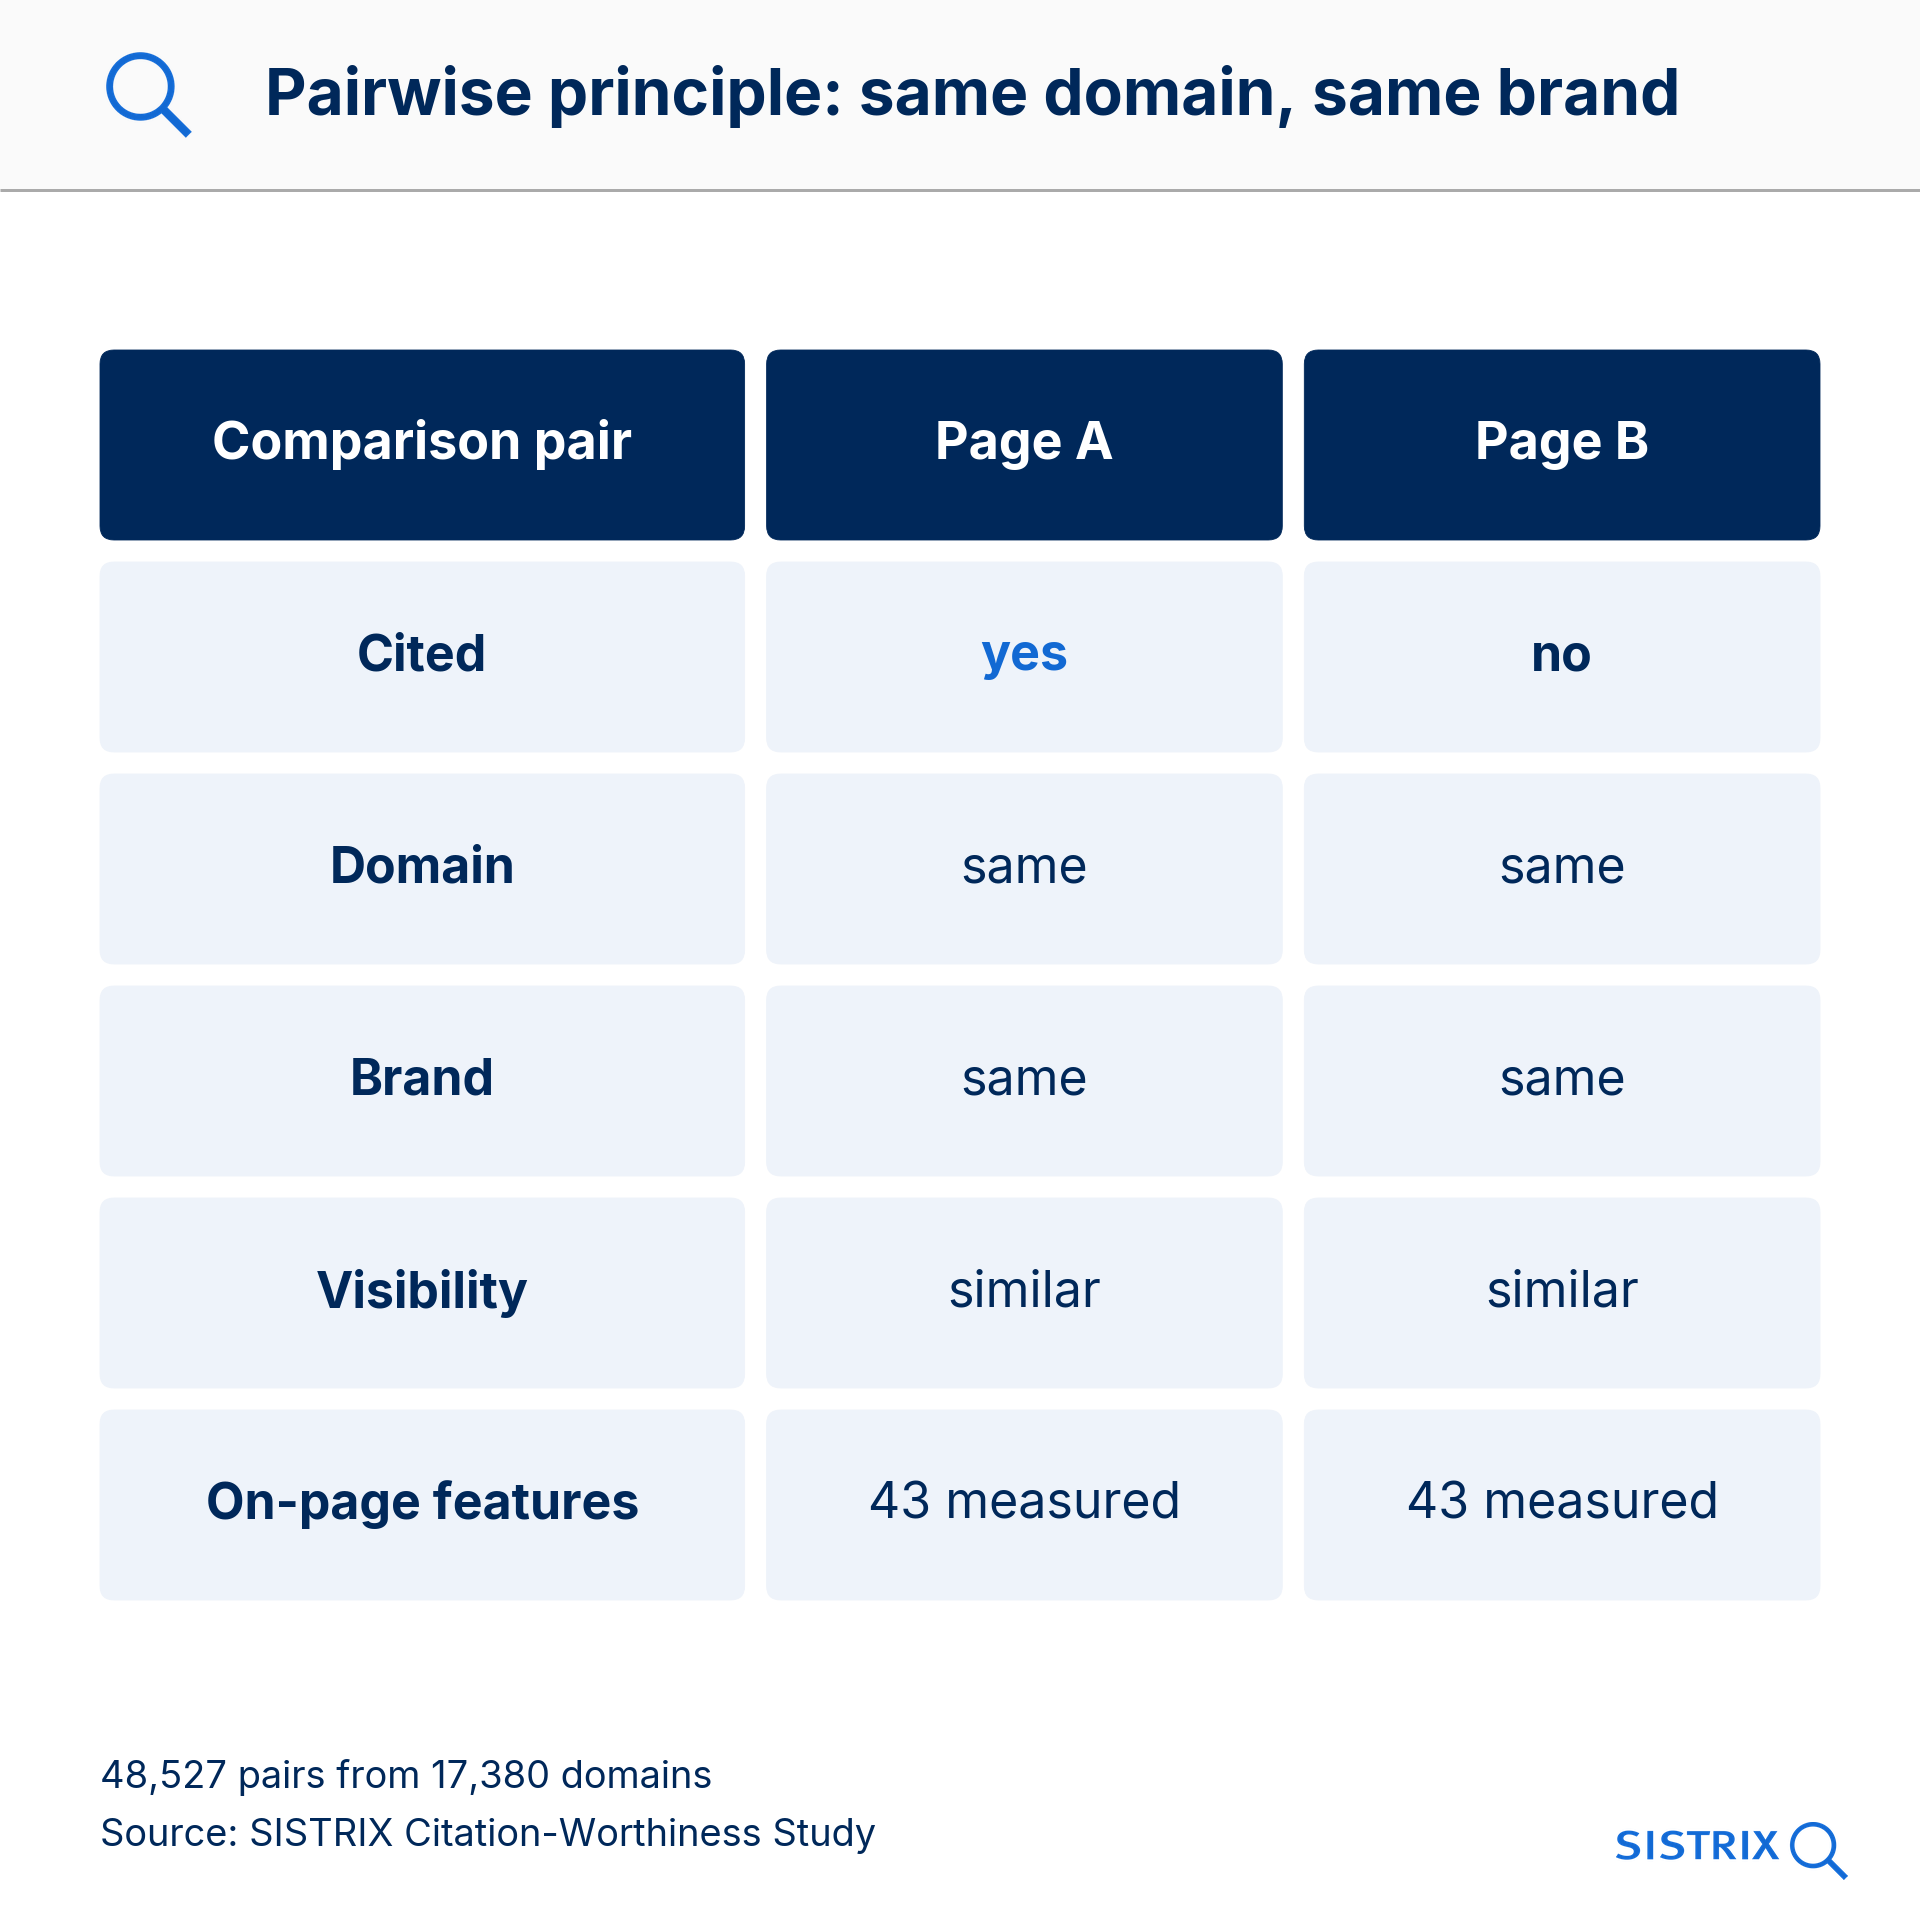
La base sono 48.527 URL citati dall’AI Index di SISTRIX per l’area DACH nel secondo trimestre 2026, circa 16.000 ciascuno da ChatGPT, AI Mode e AI Overviews. Ogni pagina citata viene messa a confronto con una pagina non citata dello stesso dominio. In questo modo la forza del dominio e del brand non incide e resta solo ciò che dipende dalla pagina stessa. In totale sono confluiti nell’analisi 96.418 URL di 17.380 domini, con 43 caratteristiche ciascuno. Per inciso, quasi la metà delle pagine citate sono guide e contenuti how-to (48,7%), e la maggior parte proviene da siti di brand (38,7%). La classificazione per tipo di dominio e di contenuto è stata effettuata da Gemini 3.5 Flash. Una verifica incrociata con Gemini 3.1 Pro ha mostrato una concordanza dell’84%, e in più è stato verificato manualmente un campione di 100 pagine.
I nostri test hanno mostrato quanto conti la dimensione del set di dati: con 833 URL lo schema FAQ era il 23% meno frequente sulle pagine citate, con 4.600 URL il 31% più frequente e con 96.418 URL il 19% più frequente. Solo a partire da circa 5.000 URL il risultato indicava in modo affidabile la stessa direzione. Ne deriva una semplice regola pratica sulla dimensione di uno studio: non fidarti di uno studio GEO con meno di 5.000 URL. Questo vale anche per il presente studio: i valori per singoli sottogruppi, come i siti istituzionali o le enciclopedie, si basano su un numero di URL nettamente inferiore e vanno letti con la dovuta cautela.
Come ogni studio, anche questo ha i suoi limiti: mostra correlazioni, non cause dimostrate, ed è un’istantanea dell’area DACH. Perplexity, Claude e la chat di Gemini non sono stati analizzati. È prevista una nuova edizione.
FAQ: domande frequenti sullo studio sulla Citation Worthiness
La Citation Worthiness descrive la probabilità che sistemi AI come ChatGPT, l’AI Mode o le AI Overviews di Google citino una pagina come fonte.
Soprattutto un indice dei contenuti (citazioni 1,7 volte più frequenti), lo schema Article (1,6), lo schema FAQPage (1,5) e un box autore con foto (1,4). Le pagine che combinano molte di queste caratteristiche vengono citate 2,1 volte più spesso di quelle poco ottimizzate.
Allo stato attuale no. Non si rileva alcun effetto misurabile sulle citazioni AI.
Dipende dal tipo di schema. Gli schema Article e FAQPage sono associati a un numero di citazioni nettamente maggiore, mentre i markup Breadcrumb, HowTo e QAPage non mostrano alcun effetto. Lo schema Recipe è addirittura associato ad appena un decimo delle probabilità di citazione.
Tra due pagine dello stesso dominio, quella con una determinata caratteristica viene citata X volte più spesso di quella senza. Tecnicamente si tratta di odds ratio che, con un tasso di citazione di circa l’1,4%, corrispondono praticamente al rapporto tra le frequenze.
Con una regressione logistica condizionale, che confronta ogni pagina citata con una pagina non citata dello stesso dominio. I test multipli sulle 43 caratteristiche sono stati corretti con il metodo di Benjamini-Hochberg. Le caratteristiche relative a title e H1 sono state aggiunte in un secondo momento e vanno intese come primi indizi.
Prova SISTRIX gratis
- Account di prova gratuito per 7 giorni
- Nessun obbligo, né disdetta necessaria
- Onboarding personalizzato con esperti